Beschreibung
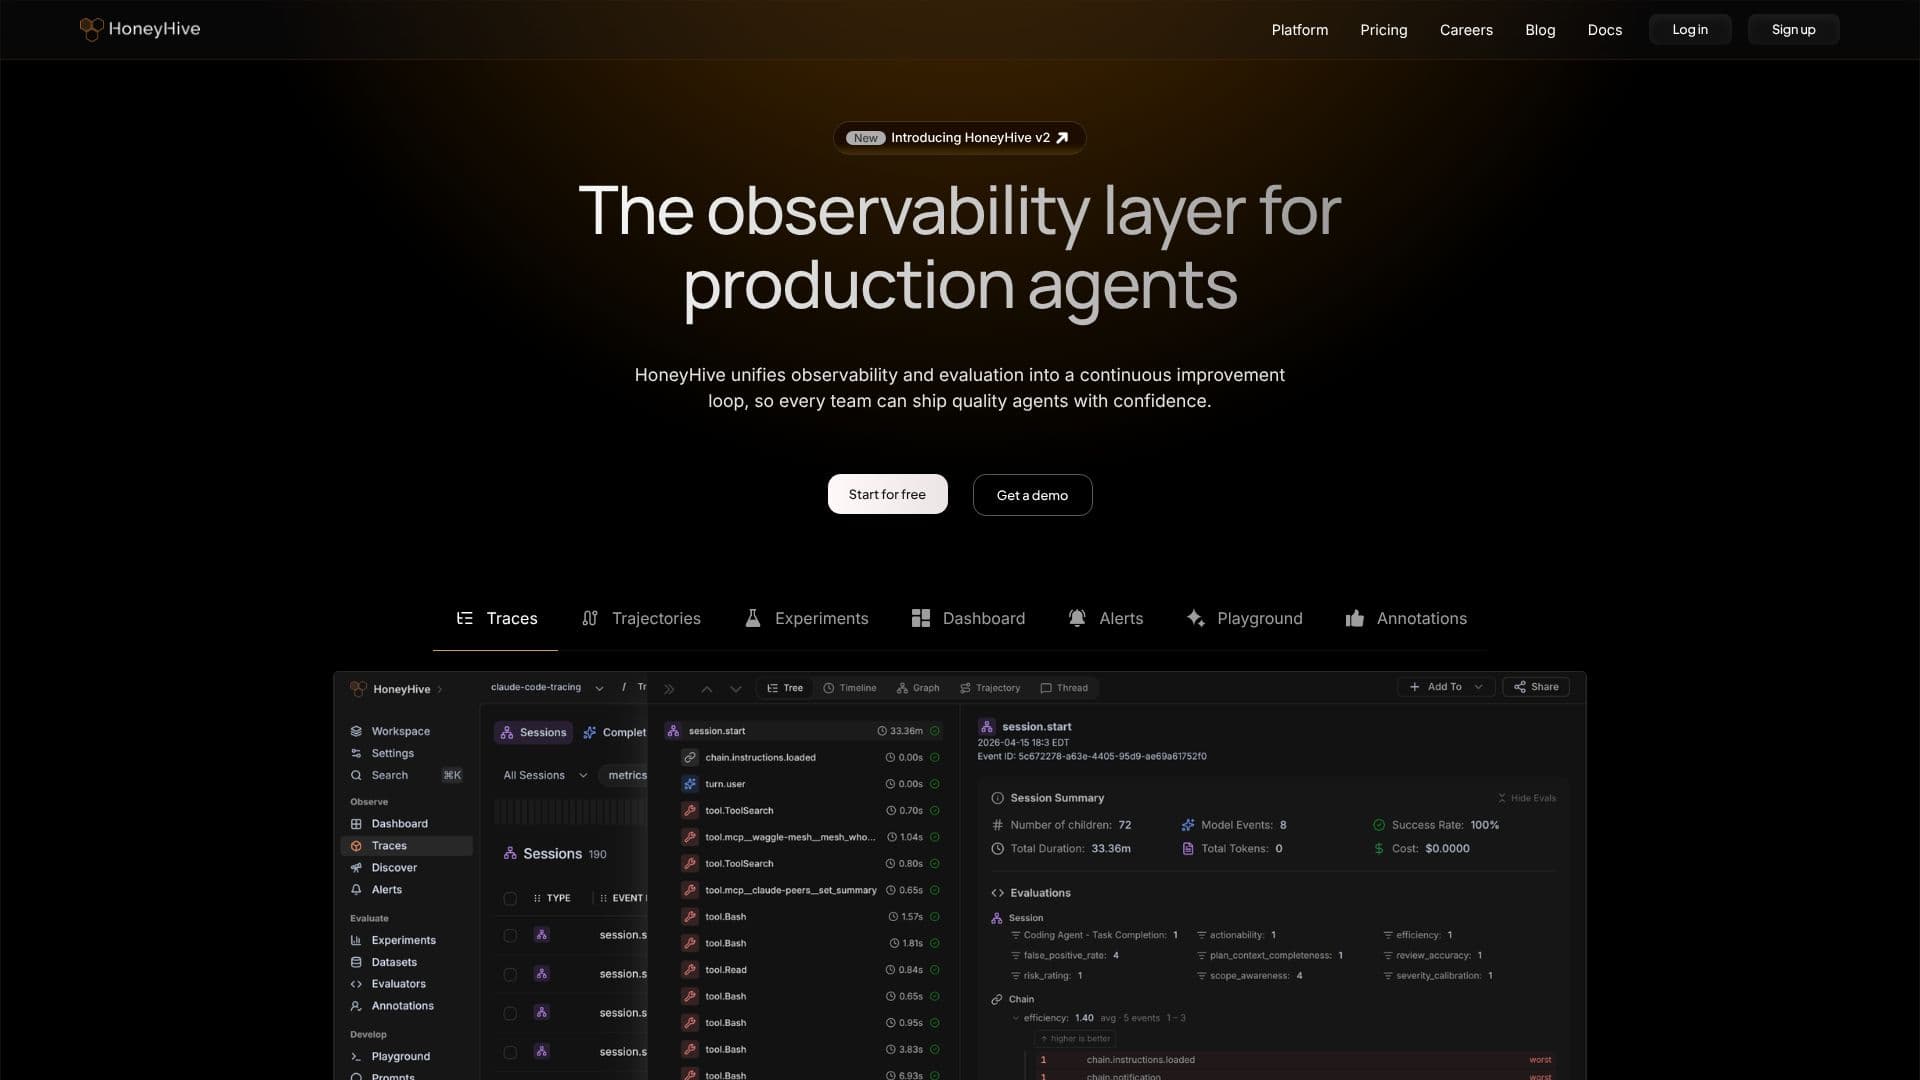
HoneyHive ist die Observability-Schicht, die für Produktions-KI-Agenten entwickelt wurde und Observability und Evaluierung in einem kontinuierlichen Verbesserungszyklus vereint. Dies befähigt jedes Team in Ihrem Unternehmen, qualitativ hochwertige Agenten mit Zuversicht auszuliefern. Die Plattform bietet eine umfassende Suite von Tools, um die Leistung von KI-Agenten zu verstehen, zu debuggen und zu verbessern.
Weiterlesen
Im Kern bietet HoneyHive Funktionen für verteiltes Tracing, mit denen Sie jeden Agenten, auf jedem Framework, überall einsehen können. Durch die Instrumentierung von Agenten mit OpenTelemetry wird eine gemeinsame Wahrheitsquelle für das Debugging des Agentenverhaltens geschaffen, die mit über 100 LLMs und Agenten-Frameworks funktioniert. Online-Evaluierungsfunktionen ermöglichen die Live-Erkennung von Fehlern über Agenten hinweg, während Session-Replays im Playground eine detaillierte Überprüfung von Chat-Interaktionen ermöglichen. Erweiterte Filter-, Gruppierungs-, Graph- und Timeline-Ansichten helfen beim Debugging komplexer Multi-Agenten-Systeme, ergänzt durch die Erfassung von Benutzerfeedback für implizite und explizite Signale.
Monitoring und Alerts werden kontinuierlich und skalierbar verwaltet. HoneyHive wertet Live-Traces aus, überwacht reales Benutzerfeedback und warnt bei kritischen Fehlermodi. Die Online-Evaluierung kann LLM-as-a-Judge oder benutzerdefinierten Code nutzen. Alerts und Drift-Erkennung identifizieren proaktiv Agentenfehler, bevor Benutzer dies tun, mit Automatisierungen, um fehlerhafte Prompts zu Datensätzen hinzuzufügen oder menschliche Überprüfungen auszulösen. Benutzerdefinierte Dashboards bieten schnelle Einblicke in wichtige Metriken, und explorative Analysen helfen, Muster über Millionen von Traces hinweg zu entdecken. Die Ursachenanalyse wird durch KI verbessert, die Coding-Agenten Kontext zur Behebung von Problemen liefert.
Die Zuversicht beim Ausliefern von Änderungen wird durch Offline-Evaluierungen gestärkt. Produktionsfehler können in Test-Suiten umgewandelt, neue Änderungen mit Baselines verglichen und Regressionen vor jeder Veröffentlichung erkannt werden. Experimente ermöglichen Offline-Tests gegen große Datensätze mit zentralisiertem Datenmanagement und benutzerdefinierten Evaluatoren. Menschliche Überprüfung durch Fachexperten wird erleichtert, und die Regressionserkennung identifiziert kritische Probleme während der Iteration. CI/CD-Integration ermöglicht automatisierte Test-Suiten für jeden Commit.
Die Qualität von Agenten wird durch Annotation-Queues geformt, die Fachexperten einbeziehen, um Edge-Cases zu überprüfen und Qualität zu definieren. Die Queue-Automatisierung leitet markierte Traces an die richtigen Prüfer weiter, und die menschliche Überprüfung erfolgt in einer benutzerfreundlichen Oberfläche. Benutzerdefinierte Rubriken standardisieren die Überprüfung mit geschäftsspezifischen Kriterien, und die Datenkurierung bietet Git-native Versionierung. Ein Audit-Trail erfasst Expertenfeedback zusammen mit dem Trace-Kontext, und die Evaluatoren-Abstimmung nutzt Feedback, um LLM-Evaluatoren mit Fachexperten zu verfeinern.
HoneyHive basiert auf offenen Standards und einem offenen Ökosystem, ist OpenTelemetry-nativ und Framework-agnostisch. Es lässt sich mit jedem Modell, Framework oder Agenten-Runtime integrieren, das OTel-Instrumentierung unterstützt. Entwickelt für Skalierbarkeit und standardmäßig auf Datenschutz ausgelegt, verarbeitet es sensible KI-Trace-I/O. HoneyHive wird von Fortune-500-Unternehmen für die verantwortungsvolle Skalierung von KI-Agenten vertraut. Die Plattform bietet virtuelle Daten-Planes für logische Isolation mit SaaS-, Hybrid- und Self-Hosted-Deployment-Optionen. Sicherheitsfunktionen umfassen granulare RBAC, SSO- und SAML-Integration sowie die Konformität mit SOC 2, GDPR und HIPAA. Audit-Logging stellt sicher, dass jede Aktion nachvollziehbar ist.
- KategorieMLOps & Modell-Deployment
- PreismodellKostenloser Tarif verfügbar
- BereitstellungSaaS, Hybrid, Selbstgehostet
- PlattformenWeb
HoneyHive's Kernfunktionen
Verteiltes Tracing für KI-Agenten
OpenTelemetry-native Instrumentierung
Online-Evaluierung mit LLM-as-a-Judge
Session-Replay und Playground
Monitoring und Alerting bei Agentenfehlern
Drift-Erkennung für KI-Modelle
Offline-Experimente und Regressionstests
CI/CD-Integration für KI-Agenten
Menschliche Überprüfung und Annotation-Queues
Benutzerdefinierte Rubriken zur Qualitätsdefinition
Datenkurierung und Versionierung
KI-gestützte Ursachenanalyse
Granulare rollenbasierte Zugriffskontrolle (RBAC)
SSO- & SAML-Integration
SOC 2, GDPR, HIPAA-Konformität
Wie verwendet man HoneyHive?
Instrumentieren: Integrieren Sie OpenTelemetry in Ihre KI-Agenten und Frameworks.
Beobachten: Nutzen Sie verteiltes Tracing, um das Agentenverhalten in Echtzeit zu überwachen.
Evaluieren: Führen Sie Online- und Offline-Evaluierungen durch, um Fehler zu erkennen und zu analysieren.
Alarmieren: Konfigurieren Sie Alarme für kritische Fehlermodi und Drift-Erkennung.
Verbessern: Nutzen Sie Session-Replays und menschliche Überprüfung, um die Agentenqualität zu verfeinern.
Automatisieren: Nutzen Sie CI/CD-Integration für kontinuierliche Tests und Bereitstellungen.
Analysieren: Verwenden Sie KI-gestützte Ursachenanalyse zur Problemlösung.
HoneyHive's Anwendungsfälle
- Agenten-Debugging
- Leistungsüberwachung
- Qualitätssicherung
- Kontinuierliche Verbesserung
- Regressionstests
- Debugging von Multi-Agenten-Systemen
- Integration von Benutzerfeedback
- Automatisierte Ursachenanalyse