Beschreibung
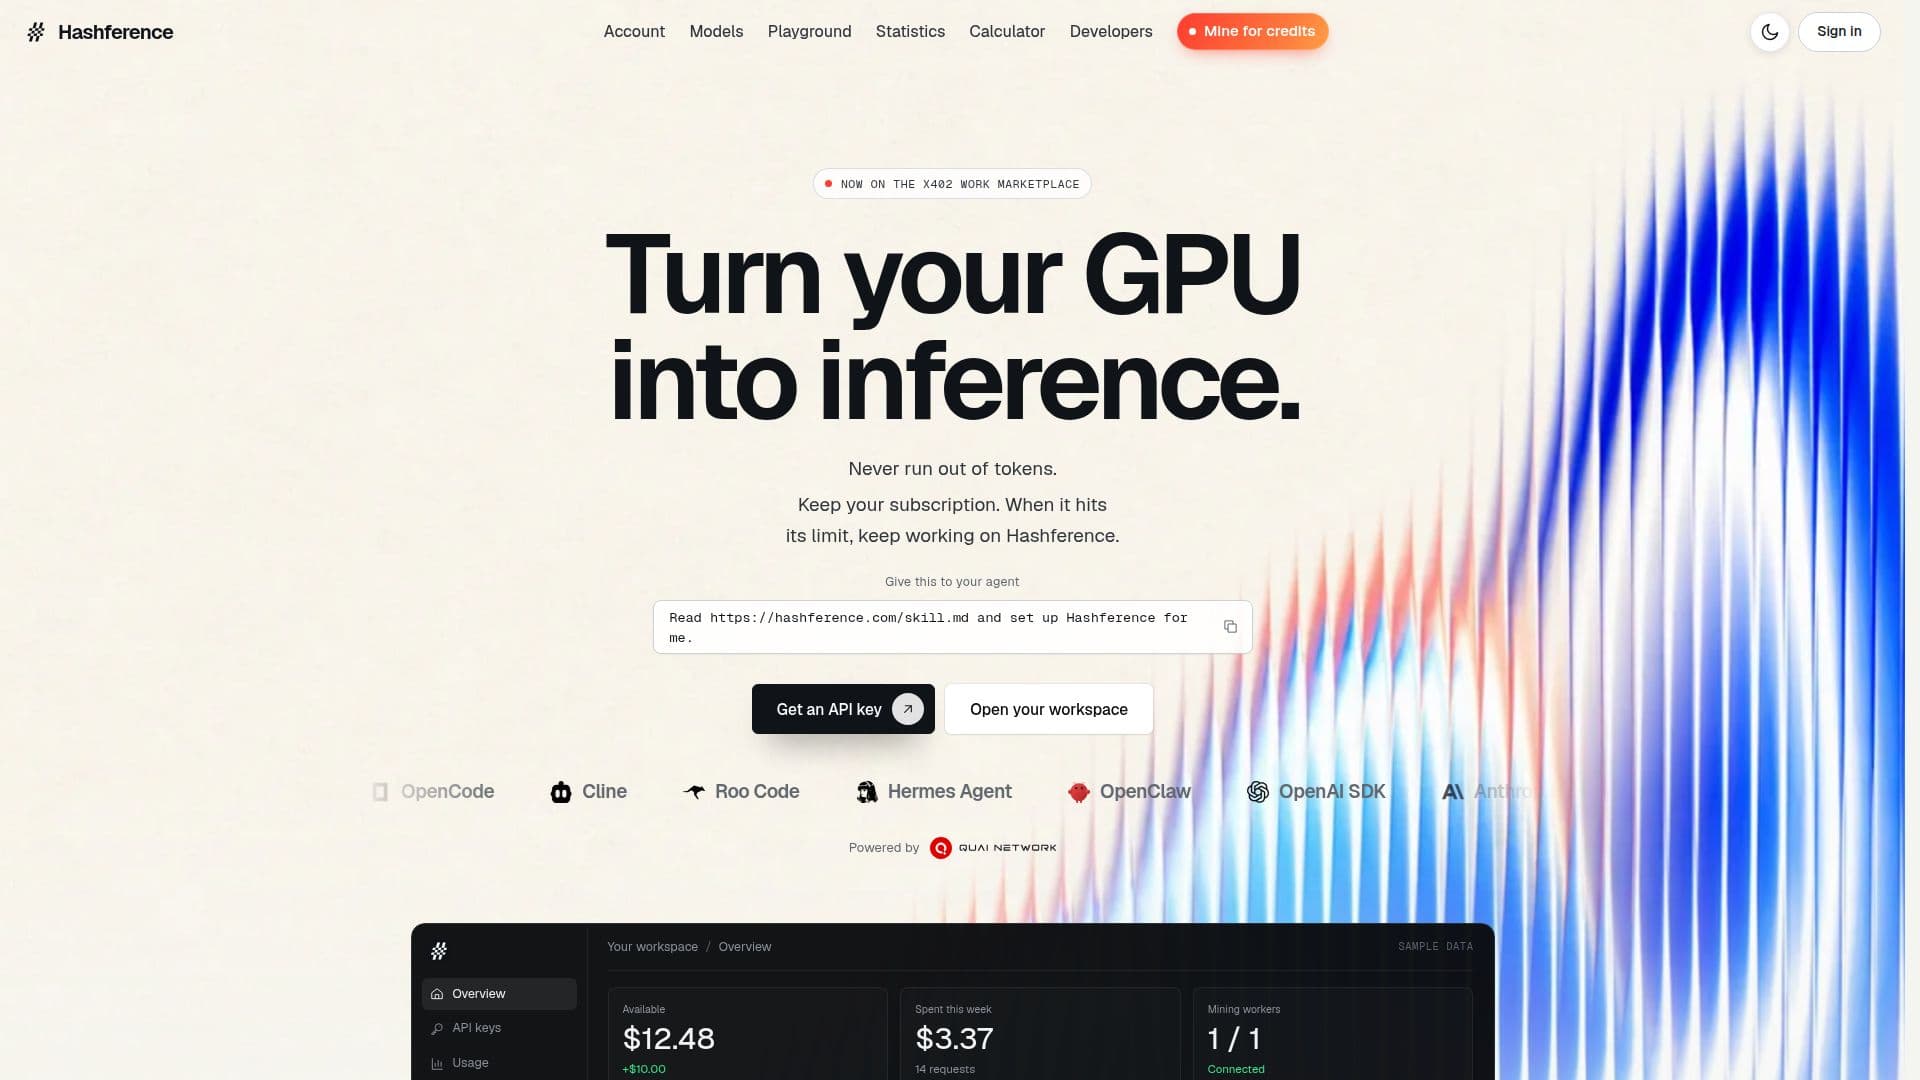
Hashference bietet eine flexible und private API-Lösung für den Zugriff auf eine Reihe von offenen KI-Modellen, einschließlich DeepSeek, Qwen, GLM, Kimi und Claude. Sie ist so konzipiert, dass sie mit bestehenden OpenAI- und Anthropic-SDKs kompatibel ist, was Entwicklern ermöglicht, sie nahtlos in ihre aktuellen Tools und Workflows zu integrieren. Die Plattform adressiert das häufige Problem des Tokenmangels, indem sie mehrere Finanzierungsoptionen bereitstellt, um einen kontinuierlichen Zugriff auf KI-Inferenzfähigkeiten zu gewährleisten.
Weiterlesen
Eine der herausragenden Eigenschaften von Hashference ist ihr vielfältiges Zahlungssystem. Benutzer können ihre API-Schlüssel finanzieren, indem sie Credits mit Kryptowährungen wie QUAI oder Stablecoins kaufen. Alternativ können sie Credits mit ihrer eigenen Hardware minen, einschließlich CPUs, GPUs und ASICs (SHA-256 für Bitcoin-Miner, Scrypt für Litecoin/Dogecoin-Miner und KawPoW für Ravencoin-ähnliche GPU-Miner). Akzeptierte Anteile aus dem Mining werden direkt in KI-Credits umgewandelt, wodurch Auszahlungsgrenzen und Abhebungsgebühren, die oft mit traditionellen Mining-Pools verbunden sind, entfallen. Für Einzelanfragen ohne Konto oder Guthaben unterstützt Hashference ein einzigartiges „Pay per Request“-Modell mit x402-Arbeit, bei dem ein Agent ein kleines Rechenrätsel löst, um die Kosten zu decken.
Der Dienst priorisiert den Datenschutz der Benutzer und erfordert keine E-Mail oder KYC (Know Your Customer) für die Kontoerstellung. Außerdem wird eine strikte Null-Retention-Politik für Eingabeaufforderungen und Antworten umgesetzt, was bedeutet, dass Benutzerdaten nicht in Datenbanken oder Protokollen gespeichert werden. Anfragen an gehostete Modelle werden über Endpunkte mit Null-Daten-Retention-Richtlinien geleitet, und alle potenziell identifizierenden Felder werden entfernt, bevor sie den Anbieter erreichen. Abrechnungsunterlagen enthalten nur Metadaten wie verwendetes Modell, Token-Zahlen, Kosten und Dauer, ohne eine Verbindung zu IP-Adressen oder Browserdetails herzustellen.
Hashference bietet auch einen Rückfallmechanismus für die Ratenbegrenzung für Tools wie Claude Code und Codex. Wenn das Hauptabonnement eines Benutzers sein Nutzungslimit erreicht, kann er nahtlos zu einem günstigeren offenen Modell auf Hashference wechseln, um seine Arbeit in derselben Sitzung fortzusetzen. Dies gewährleistet eine ununterbrochene Produktivität und bietet eine kostengünstige Alternative für laufende Aufgaben oder Unteragenten. Die Plattform unterstützt die Integration mit verschiedenen Entwickler-Tools und SDKs und ist somit eine vielseitige Option für den Zugriff auf und die Verwaltung von KI-Modellinferenz.
- KategorieKI-Modelle & LLMs
- PreismodellBezahlen nach Nutzung
- BereitstellungCloud
- PlattformenWeb
Hashference's Kernfunktionen
OpenAI-kompatible API
Anthropic-kompatible API
Zugriff auf DeepSeek, Qwen, GLM, Kimi und Claude Modelle
Bezahlung mit Kryptowährung (QUAI, Stablecoins)
Credits mit CPU, GPU oder ASIC minen
Bezahlung pro Anfrage mit x402-Arbeit
Keine E-Mail für die Kontoerstellung erforderlich
Kein KYC für die Kontoerstellung erforderlich
Null Datenretention für Eingabeaufforderungen und Antworten
API-Schlüssel werden als Hashes gespeichert
Ratenlimit-Rückfall für Claude Code und Codex
Unterstützt die Delegation von Unteragentenmodellen
Funktioniert mit OpenAI SDK, Anthropic SDK, Vercel AI SDK, LangChain, n8n
Integration mit Claude Code, Cursor, VS Code, Codex
Wie verwendet man Hashference?
Workspace erstellen: Richten Sie einen Hashference-Workspace ein, um API-Schlüssel und Guthaben zu verwalten.
Workspace finanzieren: Wählen Sie, ob Sie Credits mit Krypto kaufen, Credits mit Hardware minen oder x402 für Zahlungen pro Anfrage verwenden möchten.
API-Schlüssel generieren: Erstellen Sie einen API-Schlüssel innerhalb Ihres Workspaces zur Authentifizierung.
Tools konfigurieren: Richten Sie Ihre bestehenden OpenAI- oder Anthropic-SDKs und Tools (z. B. Claude Code, Cursor) auf Hashference mit den bereitgestellten Umgebungsvariablen aus.
Anfragen stellen: Verwenden Sie Ihre konfigurierten Tools, um Anfragen an verschiedene KI-Modelle zu senden, die über die Hashference-API verfügbar sind.
Nutzung überwachen: Verfolgen Sie Ihre API-Nutzung und Ihr Guthaben mit detaillierten Buchungseinträgen für jede Anfrage.
Hashference's Anwendungsfälle
- Kosteneffektive KI-Inferenz
- Ununterbrochene KI-Workflows
- Privater KI-API-Zugriff
- Integration von Entwickler-Tools
- Hardwarebasiertes Verdienen von Credits
- Flexible Bezahlung für KI
- Delegation von Unteragentenmodellen
- Experimentieren mit offenen Modellen