Beschreibung
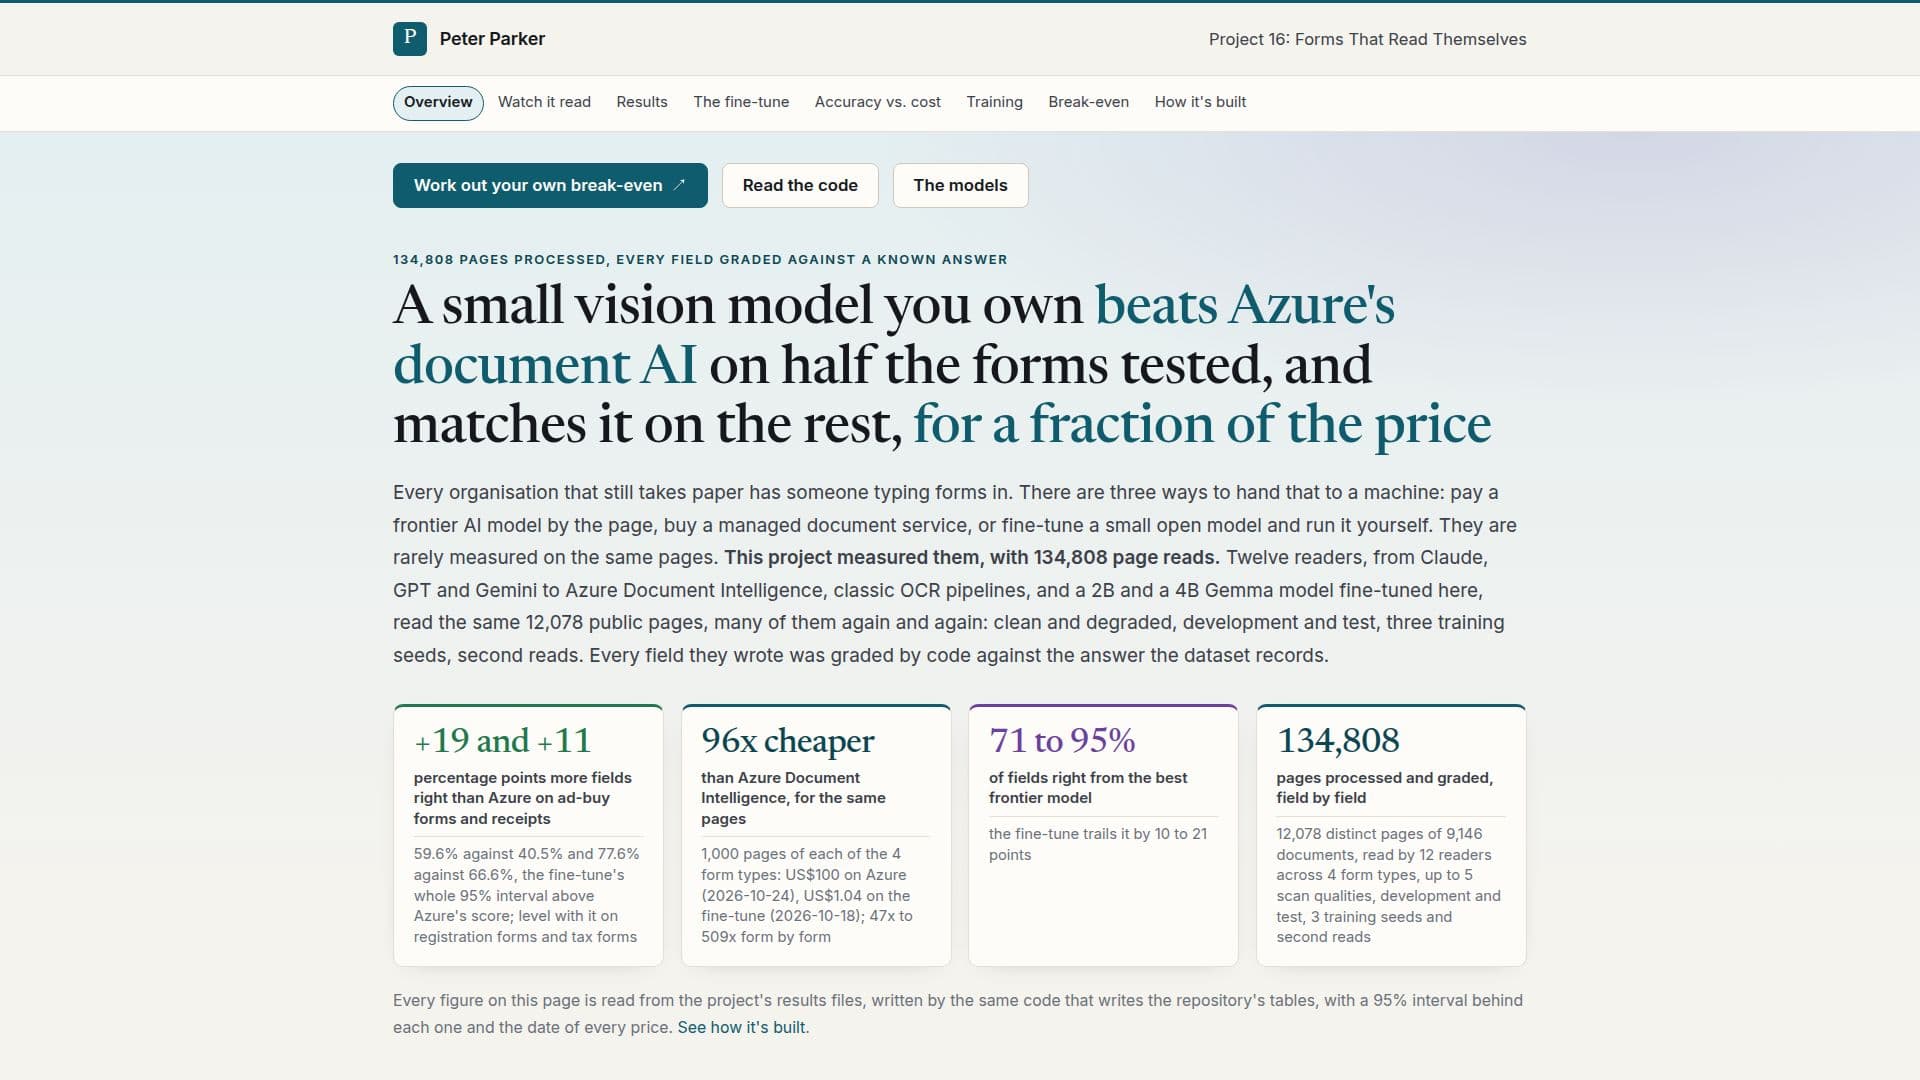
Forms That Read Themselves führt eine umfassende Bewertung von zwölf verschiedenen Lesemodellen für gescannte Formulare ein, die von hochmodernen Vision-APIs bis hin zu einem speziell für diesen Zweck fein abgestimmten 2B-Parameter-Modell reichen. Das Hauptangebot ist ein kleines Vision-Modell, das Benutzer besitzen und betreiben können und eine kostengünstige Alternative zu kommerziellen Lösungen wie Azure Document Intelligence bietet.
Weiterlesen
Die Plattform bewertet jedes Lesemodell sorgfältig Feld für Feld anhand öffentlicher Datensätze mit bekannten Antworten, einschließlich der NIST Special Database 2 für US-Steuerformulare von 1988, den Einreichungen des Foreign Agents Registration Act, FCC-Werbeaufträgen und CORD v2-Quittungen. Dieses rigorose Benchmarking zeigt, dass das fein abgestimmte Modell bei der Hälfte der getesteten Formulararten besser abschneidet als Azure Document Intelligence und in der restlichen Leistung gleichauf ist, während es zu einem Bruchteil des Preises arbeitet. Beispielsweise erreicht das fein abgestimmte Modell bei Werbeformularen eine Genauigkeit von 59,6 % im Vergleich zu 40,5 % von Azure und bei Quittungen 77,6 % im Vergleich zu 66,6 %.
Ein zentrales Ergebnis ist die transformative Wirkung des Fine-Tunings auf kleinere Modelle. Unabgestimmte Modelle wie Gemma 4 E2B zeigen eine deutlich niedrigere Genauigkeit (z. B. 15,0 % bei Steuerformularen), die sich dramatisch auf 73,6 % verbessert, nachdem sie fein abgestimmt wurden. Dieser Prozess, der nur 8 Minuten bis 4,9 Stunden auf einer gemieteten GPU in Anspruch nehmen kann, macht diese kleineren Modelle äußerst wettbewerbsfähig. Das fein abgestimmte Modell zeigt auch eine niedrigere Rate an erfundenen Werten im Vergleich zu hochmodernen Modellen bei bestimmten Formulararten, wie z. B. Registrierungsformularen und Quittungen, was entscheidend für Anwendungen ist, bei denen ein leeres Feld einem selbstbewussten, aber falschen Eintrag vorzuziehen ist.
Während hochmoderne Vision-Modelle wie GPT-6.1 Sol und Gemini 3.8 Flash im Allgemeinen eine höhere Genauigkeit erreichen, bietet das fein abgestimmte Modell ein überzeugendes Gleichgewicht zwischen Leistung und Kosten. Beispielsweise erreicht es bei Quittungen eine Genauigkeit von 77,6 % für 0,16 US-Dollar pro tausend Seiten, verglichen mit 76,7 % von Claude Haiku 5.5 für 0,38 US-Dollar. Ein wesentlicher Vorteil des Besitzes und Betriebs des Modells auf einer Verbraucher-GPU ist der verbesserte Datenschutz, da keine Seiten das Netzwerk des Benutzers verlassen müssen.
Das Projekt hebt auch die Robustheit von Vision-Modellen gegenüber Scan-Degradierung hervor. Im Gegensatz zu OCR-basierten Pipelines, die bei schlechter Scan-Qualität drastische Genauigkeitsverluste erleiden, behalten Vision-Modelle, die direkt Pixel lesen, eine hohe Leistung bei. Es ist jedoch wichtig zu beachten, dass kein Leser 99 % Genauigkeit bei allen Feldern erreicht hat, was bedeutet, dass eine menschliche Überprüfung für kritische Anwendungen weiterhin notwendig bleibt. Die Modelle automatisieren hauptsächlich den Tippprozess, nicht die endgültige Überprüfung.
Die Architektur umfasst das Training von offenen Gewicht-Modellen Gemma 4 E2B und E4B unter Verwendung von QLoRA, wobei die Basis-Modellgewichte in 4 Bit eingefroren werden, während kleine Adaptermatrizen trainiert werden. Diese Adapter werden mit vLLM auf einer RTX 3090 GPU bereitgestellt, was eine effiziente, lokale Bereitstellung ermöglicht. Die Website bietet einen Rechner, um den Break-Even-Punkt zwischen API-Kosten und GPU-Miete zu bestimmen, und betont, dass die tatsächlichen Kosten eines eigenen Modells von seiner Nutzung abhängen.
- KategorieComputer-Vision-Tools
- PreismodellGPU Rental Cost
- BereitstellungOn-Premises
- PlattformenWeb
Forms That Read Themselves's Kernfunktionen
Fein abgestimmte Vision-Modelle zur Extraktion von gescannten Formularen
Benchmarking gegen hochmoderne Vision-APIs (GPT-6.1 Sol, Claude Sonnet, Gemini Flash)
Vergleich mit Azure Document Intelligence
Unterstützung für verschiedene Formulararten: Registrierungsformulare, Werbeformulare, Quittungen, Steuerformulare
Feldgenaue Genauigkeitsbewertung auf öffentlichen Datensätzen
Kostengünstige Alternative zu kommerziellen APIs
Lokale Bereitstellung auf Verbraucher-GPUs (z. B. RTX 3090)
Reduzierte Erfindung von Werten bei bestimmten Formulararten
Robustheit gegenüber Scan-Degradierung (Rauschen, Unschärfe, Verzerrung, verlorener Kontrast)
Detaillierte Leistungskennzahlen einschließlich korrekter Felder und Kosten pro tausend Seiten
Offene Gewicht-Basis-Modelle (Gemma 4 E2B, E4B) für das Fine-Tuning verwendet
QLoRA-Fine-Tuning-Rezept für effizientes Training auf einzelnen GPUs
vLLM zur Bereitstellung fein abgestimmter Modelle
Rechner für die Kostenanalyse zwischen API und eigenem GPU-Besitz
Datenschutz durch Beibehaltung der Seiten innerhalb Ihres Netzwerks
Wie verwendet man Forms That Read Themselves?
Wählen Sie einen Leser: Wählen Sie aus verschiedenen Vision-Modellen oder OCR-Pipelines, um deren Leistung zu vergleichen.
Passen Sie die Scan-Qualität an: Simulieren Sie verschiedene Degradierungsstufen (Rauschen, Unschärfe, Verzerrung, verlorener Kontrast), um die Auswirkungen auf die Genauigkeit zu beobachten.
Überprüfen Sie die Ergebnisse Feld für Feld: Sehen Sie, welche Felder jeder Leser korrekt extrahiert, grün markiert, und welche falsch sind, rot und gestrichelt markiert.
Analysieren Sie Genauigkeit und Kosten: Vergleichen Sie den Anteil der richtigen Felder und die Kosten pro tausend Seiten für verschiedene Leser und Formulararten.
Verstehen Sie die Auswirkungen des Fine-Tunings: Beobachten Sie, wie das Fine-Tuning die Genauigkeit kleinerer Modelle bei bestimmten Formulararten erheblich verbessert.
Bewerten Sie die Bereitstellungskosten: Verwenden Sie den bereitgestellten Rechner, um die wirtschaftliche Rentabilität der Miete einer GPU im Vergleich zur Nutzung kommerzieller APIs basierend auf Ihrem Volumen zu bestimmen.
Zugriff auf Adapter: Laden Sie verfügbare fein abgestimmte Adapter für Quittungen, Werbeformulare und Steuerformulare von Hugging Face herunter.
Forms That Read Themselves's Anwendungsfälle
- Automatisierte Formulardatenextraktion
- Kosteneffiziente Dokumentenverarbeitung
- Lokale Datenverarbeitung
- Benchmarking von KI-Vision-Modellen
- Verbesserung der OCR-Genauigkeit
- Entwicklung benutzerdefinierter Modelle