Zum Hauptinhalt springen
ToolPotion
KI-Berater
Einreichen

Decibri

KI-AppsKI-Agenten-BuilderAudio, Stimme & Musik#45Kostenlos · Windows, macOS, Linux, Browser

Decibri ist eine einheitliche Audio-Schicht für KI-Agenten und Voice-AI-Anwendungen, die Echtzeit-Mikrofonaufnahme, Lautsprecherausgabe und Sprachaktivitätserkennung bietet. Es unterstützt plattformübergreifend Python, Node.js und Rust und bietet vorgefertigte Binärdateien für eine einfache Installation. Decibri wurde für Echtzeitsysteme entwickelt und vereinfacht die Audio-Infrastruktur für Sprachanwendungen, wodurch eine nahtlose Integration mit verschiedenen Sprach- und Audioverarbeitungs-Engines ermöglicht wird.

URL besuchen
Teilen
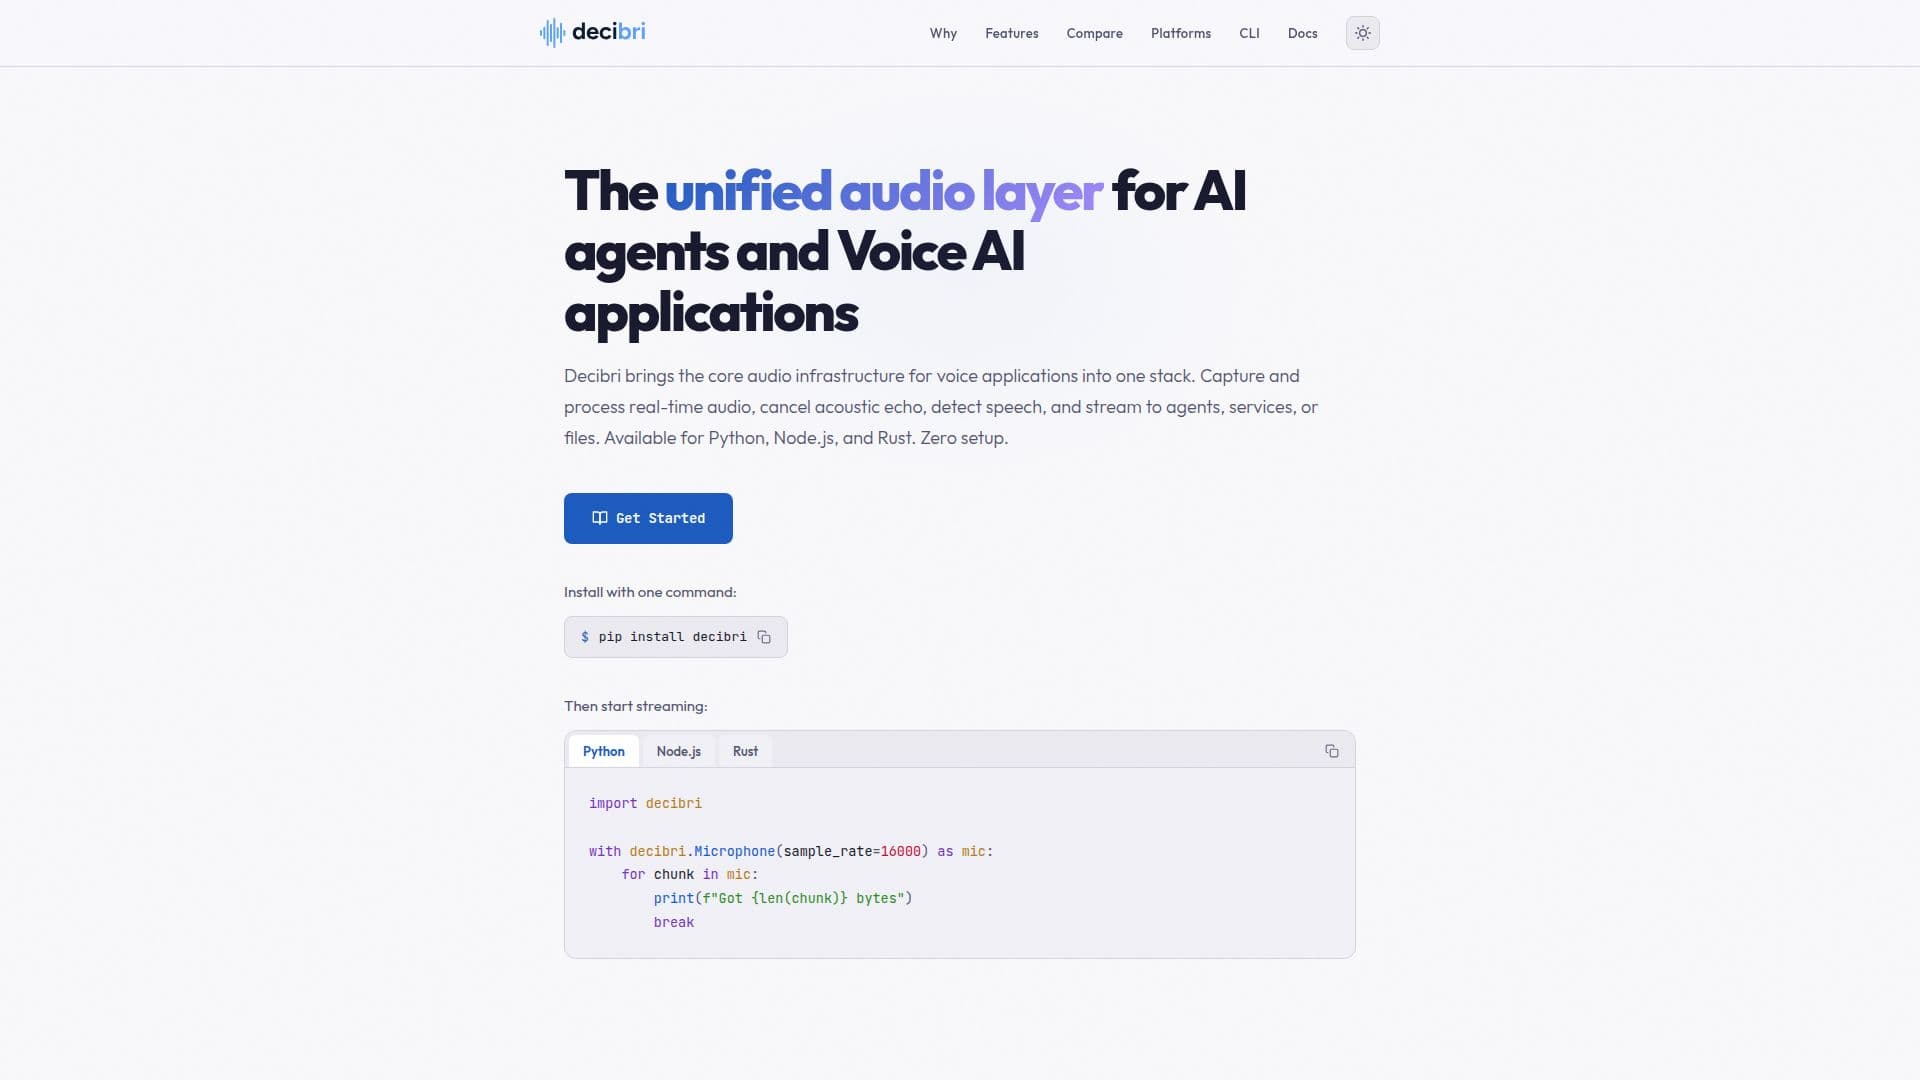
Screenshot von Decibri

Decibri dient als eine einheitliche Audio-Schicht, die speziell für KI-Agenten und Voice-AI-Anwendungen entwickelt wurde. Es bietet wesentliche Echtzeit-Audio-Funktionen, einschließlich Mikrofonaufnahme, Lautsprecherausgabe und Sprachaktivitätserkennung (VAD). Die Plattform unterstützt mehrere Programmiersprachen, nämlich Python, Node.js und Rust, was sie vielseitig für verschiedene Entwicklungsumgebungen macht.

Weiterlesen

Ein wesentlicher Vorteil von Decibri ist die einfache Installation und die plattformübergreifende Kompatibilität. Es bietet vorgefertigte Binärdateien für Python und Node.js auf allen unterstützten Plattformen (Windows, macOS, Linux), wodurch die Notwendigkeit für Kompilierung oder komplexe Build-Tools entfällt. Dieser „Null-Setup“-Ansatz stellt sicher, dass Entwickler schnell Echtzeit-Audio-Funktionalitäten in ihre Projekte integrieren können. Der Rust-Kern, der die Python-, Node.js- und Rust-Pakete antreibt, wird in nativen Code kompiliert, was eine vorhersehbare, latenzarme Audioausgabe direkt von der Audio-Schicht des Betriebssystems gewährleistet.

Decibri erfasst Audio direkt von der Audio-Schicht des Betriebssystems und liefert standardmäßig 100 ms Audio-Chunks im 16-Bit vorzeichenbehafteten PCM-Format, das der Standard ist, der von den meisten Sprach- und Wake-Word-Engines wie Vosk, sherpa-onnx und whisper.cpp erwartet wird. Ein 32-Bit Float-Format ist ebenfalls verfügbar. Es unterstützt stream-native Idiome für jede Sprache, sodass Entwickler Audio effizient an Dateien, WebSockets oder Sprachagenten weiterleiten können. Die Plattform enthält auch ein gebündeltes Silero VAD v6.2-Modell für eine präzise Sprachdetektion in lauten Umgebungen, das lokal über ONNX Runtime ohne Cloud-APIs ausgeführt wird.

Über die grundlegende Aufnahme und Wiedergabe hinaus bietet Decibri fortschrittliche Audioverarbeitungsfunktionen über seine Audio Capture Engine (ACE), einschließlich DC-Entfernung, Rauschunterdrückung, Hochpassfilterung, automatische Verstärkungsregelung und Limiting. Es bietet auch eine akustische Echo-Unterdrückung (AEC), um Lautsprechergeräusche von der Mikrofonaufnahme zu entfernen. Für die Offline-Verarbeitung ermöglicht der Audio File Processor (AFP) die Konditionierung von aufgenommenen oder im Speicher befindlichen Samples. Decibri integriert sich mit zahlreichen Speech-to-Text (STT)-Anbietern, sowohl cloudbasiert (AssemblyAI, AWS Transcribe, Azure AI Speech, Deepgram, Google Cloud Speech-to-Text, Mistral Voxtral, OpenAI Realtime API) als auch lokal (Sherpa-ONNX, Whisper.cpp), sowie mit lokalem Text-to-Speech (TTS) mit dem Kokoro-Modell und Keyword Spotting (KWS) mit Sherpa-ONNX.

Decibri ist für Echtzeitsysteme konzipiert und gewährleistet latenzarme Audio-I/O ohne externe Audio-Tools oder plattformspezifische Handhabung. Es unterstützt asynchrone Operationen in Python mit `asyncio` und funktioniert sowohl in Node.js als auch in Browserumgebungen aus einem einzigen Paket. Das Tool `decibri-cli` bietet Befehlszeilenfunktionen für Audioaufnahme, Wiedergabe und Geräteauflistung, wodurch seine Nützlichkeit für Skripting und CI/CD-Pipelines weiter erhöht wird.

  • KategorieKI-Agenten-Builder
  • PreismodellKostenlos
  • BereitstellungLokal
  • PlattformenWindows, macOS, Linux, Browser

  • Echtzeit-Mikrofonaufnahme

  • Lautsprecherausgabe und Wiedergabe

  • Sprachaktivitätserkennung (VAD)

  • Plattformübergreifende Unterstützung (Python, Node.js, Rust)

  • Vorgefertigte Binärdateien für Null-Setup

  • Direkter Zugriff auf die Audio-Schicht des Betriebssystems

  • 16-Bit PCM und 32-Bit Float Audioausgabe

  • Asynchrone API-Unterstützung (asyncio für Python)

  • Browserkompatibilität (Node.js-Paket)

  • Audio Capture Engine (DC-Entfernung, Rauschunterdrückung, AGC)

  • Akustische Echo-Unterdrückung (AEC)

  • Lokale ML-Spracherkennung (Silero VAD)

  • Integration mit Cloud-STT-Diensten

  • Integration mit lokalen STT/TTS/KWS-Modellen

  • Befehlszeilenschnittstelle (decibri-cli)

  1. Installieren Sie Decibri: Verwenden Sie `pip install decibri` für Python oder `npm install decibri` für Node.js, um die vorgefertigten Binärdateien zu erhalten.

  2. Mikrofon öffnen: Nutzen Sie `decibri.Microphone.open()` in Python oder `new Microphone()` in Node.js, um mit der Audioaufnahme zu beginnen.

  3. Audio streamen: Lesen Sie Audio-Chunks mit Python-Iteratoren, Node.js Readable Streams oder Rust-Kanälen.

  4. Audio verarbeiten: Wenden Sie integrierte Konditionierungen wie DC-Entfernung, Rauschunterdrückung oder akustische Echo-Unterdrückung an.

  5. Sprache erkennen: Aktivieren Sie das gebündelte Silero VAD-Modell für die lokale Sprachaktivitätserkennung.

  6. Integration mit KI-Diensten: Leiten Sie rohes PCM-Audio an Speech-to-Text-Dienste, Sprachagenten oder andere KI-Modelle weiter.

  7. Audio abspielen: Verwenden Sie die Speaker-API von Decibri, um Audio über den Systemlautsprecher abzuspielen.

  8. Auf Datei aufnehmen: Verwenden Sie `record_to_file()`, um einfache Audioaufnahmen zu machen oder vollständige Streaming-Kontrolle für fortgeschrittene Anwendungsfälle.

  • Echtzeit-Sprach-KI-Agenten
  • Speech-to-Text-Integration
  • Sprachaktivitätserkennung
  • Audioaufnahme für ASR
  • Plattformübergreifende Audioanwendungen
  • Serverseitige Sprach-Backends
  • Keyword Spotting
  • Voll-Duplex-Audio-Kommunikation

Decibri Bewertungen

Wird geladen...

Beliebte KI-Tools wie Decibri

Die Deepgram Voice Agent API ermöglicht die Erstellung von Echtzeit-Sprach-KI-Agenten unter Verwendung fortschrittlicher Sprach-zu-Text- und Text-zu-Sprach-Technologien. Sie…

KI-Sprachagenten
Tool ansehen

Die Deepgram Voice Agent API ermöglicht die Erstellung von Echtzeit-Sprach-KI-Agenten unter Verwendung fortschrittlicher Sprach-zu-Text- und Text-zu-Sprach-Technologien. Sie…

KI-Sprachagenten
Top 250 KI-Apps ansehen

Open Voice OS ist eine Community-gesteuerte Open-Source-Plattform für Sprach-KI, die den Aufbau benutzerdefinierter sprachgesteuerter Schnittstellen ermöglicht. Sie bietet NLP,…

KI-Sprachagenten

Platz 89 in KI-Sprachagenten

Tool ansehen

Community-gesteuerte Open-Source-Plattform für Sprach-KI, die den Aufbau benutzerdefinierter sprachgesteuerter Schnittstellen ermöglicht. Sie bietet NLP,…Open Voice OS ist eine Community-gesteuerte Open-Source-Plattform für Sprach-KI, die den Aufbau benutzerdefinierter sprachgesteuerter Schnittstellen ermöglicht. Sie bietet NLP,…

KI-Sprachagenten
Platz 89 in KI-Sprachagenten

Voice.ai

KI-Apps

Voice.ai ist ein Echtzeit-AI-Stimmenveränderer und eine Sprachplattform, die eine Live-Stimmtransformation über 50+ Apps, kostenlose Sprachklonung, Text-zu-Sprache, Sprachagenten…

KI-Audio-EditorenGaming und E-Sport

Platz 239 in KI-Apps

Tool ansehen

KI-Apps

Echtzeit-AI-Stimmenveränderer und eine Sprachplattform, die eine Live-Stimmtransformation über 50+ Apps, kostenlose Sprachklonung, Text-zu-Sprache, Sprachagenten…Voice.ai ist ein Echtzeit-AI-Stimmenveränderer und eine Sprachplattform, die eine Live-Stimmtransformation über 50+ Apps, kostenlose Sprachklonung, Text-zu-Sprache, Sprachagenten…

KI-Audio-EditorenGaming und E-Sport
Platz 239 in KI-Apps

Aethex

KI-Apps

AethexAI bietet End-to-End-Sprachagenten, die auf aufstrebende Märkte zugeschnitten sind. Mit proprietären Modellen und lokalisierten Lösungen ermöglicht es Unternehmen,…

KI-SprachagentenFinanzen & Banking

Platz 167 in KI-Sprachagenten

Tool ansehen

KI-Apps

AethexAI bietet End-to-End-Sprachagenten, die auf aufstrebende Märkte zugeschnitten sind. Mit proprietären Modellen und lokalisierten Lösungen ermöglicht es Unternehmen,…

KI-SprachagentenFinanzen & Banking
Platz 167 in KI-Sprachagenten

Resum

KI-Apps

Resum bietet eine Unternehmens-API und ein SDK, das entwickelt wurde, um Live-Gespräche mit benannten KI-Agenten zu verbinden. Es erfasst Audio aus verschiedenen Quellen,…

KI-Sprachagenten
Tool ansehen

KI-Apps

Bietet eine Unternehmens-API und ein SDK, das entwickelt wurde, um Live-Gespräche mit benannten KI-Agenten zu verbinden. Es erfasst Audio aus verschiedenen Quellen,…Resum bietet eine Unternehmens-API und ein SDK, das entwickelt wurde, um Live-Gespräche mit benannten KI-Agenten zu verbinden. Es erfasst Audio aus verschiedenen Quellen,…

KI-Sprachagenten
Top 250 KI-Apps ansehen

VideoSDK

KI-Apps

Eine Entwicklerplattform mit APIs und SDKs für Echtzeit-Sprach-, Video- und KI-Agenten, die es Teams ermöglicht, Audio-/Videoanrufe, Live-Streaming und KI-Sprachagenten in Web-…

KI-DevOps- & -Cloud-Tools
Tool ansehen

KI-Apps

Eine Entwicklerplattform mit APIs und SDKs für Echtzeit-Sprach-, Video- und KI-Agenten, die es Teams ermöglicht, Audio-/Videoanrufe, Live-Streaming und KI-Sprachagenten in Web-…

KI-DevOps- & -Cloud-Tools
Top 250 KI-Apps ansehen

Moonshine bietet eine sehr niedrige Latenz für Sprach-zu-Text, Intent-Erkennung und Text-zu-Sprache-Funktionen, die die Erstellung effizienter Sprachagenten und Schnittstellen…

KI-Sprachagenten
Tool ansehen

Bietet eine sehr niedrige Latenz für Sprach-zu-Text, Intent-Erkennung und Text-zu-Sprache-Funktionen, die die Erstellung effizienter Sprachagenten und Schnittstellen…Moonshine bietet eine sehr niedrige Latenz für Sprach-zu-Text, Intent-Erkennung und Text-zu-Sprache-Funktionen, die die Erstellung effizienter Sprachagenten und Schnittstellen…

KI-Sprachagenten
Top 250 KI-GitHub-Repos ansehen

iSpeech bietet eine leistungsstarke Text-to-Speech-API und ein Speech Recognition SDK, das eine natürlich klingende Sprachsynthese und Spracherkennung in über 30 Sprachen…

Text-to-Speech
Tool ansehen

Bietet eine leistungsstarke Text-to-Speech-API und ein Speech Recognition SDK, das eine natürlich klingende Sprachsynthese und Spracherkennung in über 30 Sprachen…iSpeech bietet eine leistungsstarke Text-to-Speech-API und ein Speech Recognition SDK, das eine natürlich klingende Sprachsynthese und Spracherkennung in über 30 Sprachen…

Text-to-Speech
Top 250 KI-Apps ansehen
1 von 8