الوصف
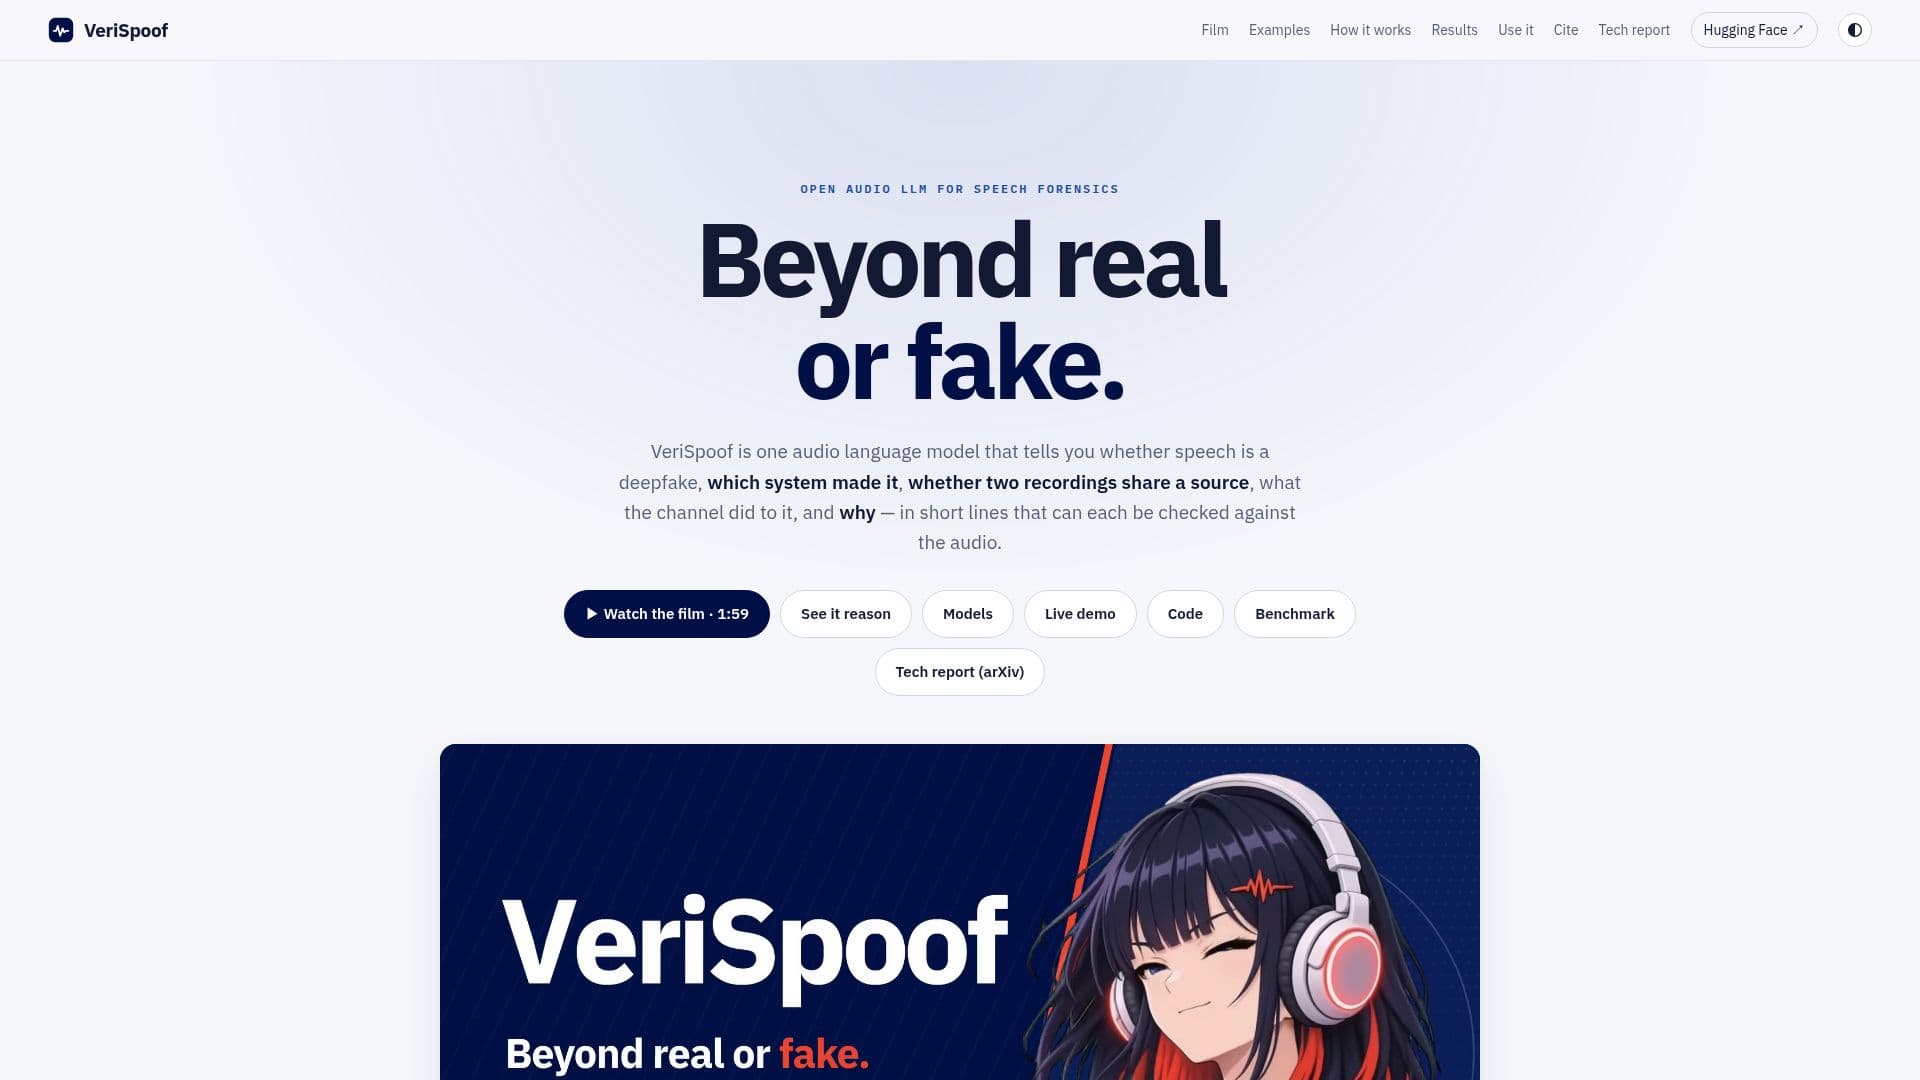
VeriSpoof هو نموذج لغة صوتية رائد تم تطويره للتحقيق المتقدم في التزييف العميق للكلام. يوفر حلاً شاملاً لتحديد ما إذا كان الكلام تزييفًا عميقًا، وتحديد النظام الذي أنشأه، وتقييم ما إذا كانت تسجيلاتان تشتركان في مصدر مشترك، وتحليل تأثيرات القناة، وشرح استنتاجاته بطريقة شفافة وقابلة للتحقق. يعمل هذا النموذج الموحد من نوع LLM (نموذج لغة كبير) على تجاوز التصنيفات البسيطة بين الحقيقي والمزيف، ويقدم رؤى مفصلة حول أصل الصوت وتلاعبه.
قراءة المزيد
لقد أظهر النموذج أداءً استثنائيًا، حيث حقق معدل خطأ متساوي مجمع قدره 2.14% عبر 14 مجموعة من Speech-DF-Arena، مما يضعه في المرتبة الأولى ككاشف وزن مفتوح. تم بناء هيكله حول نموذج LLM صوتي يقوم بمعالجة التسجيلات إلى رموز نطق وإطار، والتي تتم قراءتها بعد ذلك بواسطة نموذج MiniCPM5-2B مع LoRA. على عكس الأنظمة التقليدية، لا يعتمد VeriSpoof على رؤوس مهام منفصلة؛ بدلاً من ذلك، كل إجابة هي جملة تكون احتماليةها بمثابة الدرجة، مما يسمح بتحديد عتبات مرنة في أي نقطة تشغيل.
تعتبر قاعدة VeriSpoof قوة أساسية، حيث يتم التحقق من كل سطر من مبرراته بشكل مستقل ضد قياسات الموجات الصوتية، وظروف التسجيل، والفترات المسمى، وبيانات مولد الصوت. يضمن ذلك أن الملاحظات، وحالة القناة، وتحديد مواقع المقاطع المولدة، وملفات تعريف المصدر يتم التحقق منها بدقة. يتضمن النظام أيضًا تدريبًا مضادًا للحقائق، حيث يتم تدريب القرارات لتتبع الأدلة المذكورة، حتى عندما يتم عكس التحديد عمدًا، مما يضمن تفكيرًا قويًا ومتسقًا منطقيًا.
يهدف VeriSpoof بشكل أساسي إلى البحث في الكشف عن التزييفات العميقة، وتتبع المصادر، والتحقيقات القابلة للتفسير، ويقدم أداة قوية لتدقيق الأحكام الصوتية. يُوصى بدمج درجاته مع أدلة أخرى ومراجعة بشرية للقرارات الجنائية النهائية. يشمل المشروع نموذجين، نموذج أساسي ونموذج بلس، حيث يظهر VeriSpoof-Plus أداءً متفوقًا عبر مقاييس التقييم ومجموعات البيانات المختلفة. تم إصدار الأوزان والرمز الخاص بـ VeriSpoof بموجب ترخيص CC BY-NC 4.0، بينما تعمل نماذجه الأساسية، MiniCPM5-2B وQwen3-ASR-1.7B، بموجب Apache-2.0.
- الفئةأدوات كشف محتوى الذكاء الاصطناعي
- نموذج التسعيرFree (Open-Weight)
- النشرLocal (Inference Package)
- المنصاتWindows, macOS, Linux
الميزات الأساسية لـ VeriSpoof
كشف التزييف العميق للكلام: يحدد ما إذا كان الكلام تزييفًا عميقًا.
التحقق من المصدر: يحدد أي نظام أنشأ التزييف العميق.
نسبة المصدر: يحدد ما إذا كانت تسجيلتان تنشأ من نفس المولد.
وصف القناة: يحلل ويصف تأثيرات القناة على الصوت.
قرارات قابلة للتفسير: يوفر خطوطًا قصيرة وقابلة للتحقق تشرح استنتاجاته.
مبررات قائمة: يتم التحقق من كل ادعاء ضد قياسات الموجات الصوتية وتسميات مجموعة البيانات.
دقة عالية: حقق 2.14% معدل خطأ متساوي مجمع في Speech-DF-Arena، مما يجعله الأول بين كاشفات الوزن المفتوح.
نموذج صوتي موحد: نموذج واحد يتعامل مع جميع الأسئلة الجنائية دون رؤوس مهام منفصلة.
إجابات قائمة على الدرجات: الإجابات هي جمل تكون احتماليةها بمثابة الدرجة.
اختبار مضاد للحقائق: يسمح باستبدال التحديد المذكور لإعادة تقييم القرارات.
استنتاج غير متصل: يدعم تشغيل تسجيلات الاختبار الحقيقية دون اتصال.
نموذج مفتوح الوزن: متاح للبحث والتطوير.
ترجمات متعددة اللغات: تتضمن العروض التوضيحية للأفلام ترجمات بالصينية والإنجليزية.
موجه للبحث: مصمم للكشف عن التزييفات العميقة، وتتبع المصادر، والبحث في التحقيقات القابلة للتفسير.
أحكام قابلة للتدقيق: أربعة خطوط إلى حكم يمكن تدقيقه.
كيفية استخدام VeriSpoof؟
إدخال الصوت: قدم تسجيل صوتي واحد أو زوج من التسجيلات إلى النموذج.
المعالجة باستخدام LLM: تقوم مكونات الصوت بتحويل الإدخال إلى رموز نطق وإطار للنموذج.
استلام إجابة فورية: احصل على إجابة فورية بشأن حالة التزييف العميق أو تشابه المصدر.
مراجعة المبررات القائمة: افحص الشرح المفصل، سطرًا بسطر، لقرار النموذج.
التحقق من الادعاءات: تحقق من كل ادعاء في المبررات ضد قياسات الموجات الصوتية وتسميات مجموعة البيانات.
إجراء اختبارات مضادة للحقائق: اختياريًا، قم بتعديل معلمات مثل التحديد وأعد تشغيل النموذج لملاحظة تغييرات القرار.
حالات استخدام VeriSpoof
- بحث كشف التزييف العميق
- تتبع مصدر الصوت
- تحقيقات قابلة للتفسير
- تحليل قناة الصوت
- تحليل الكلام الاصطناعي
- تقييم كاشفات التزييف العميق