الوصف
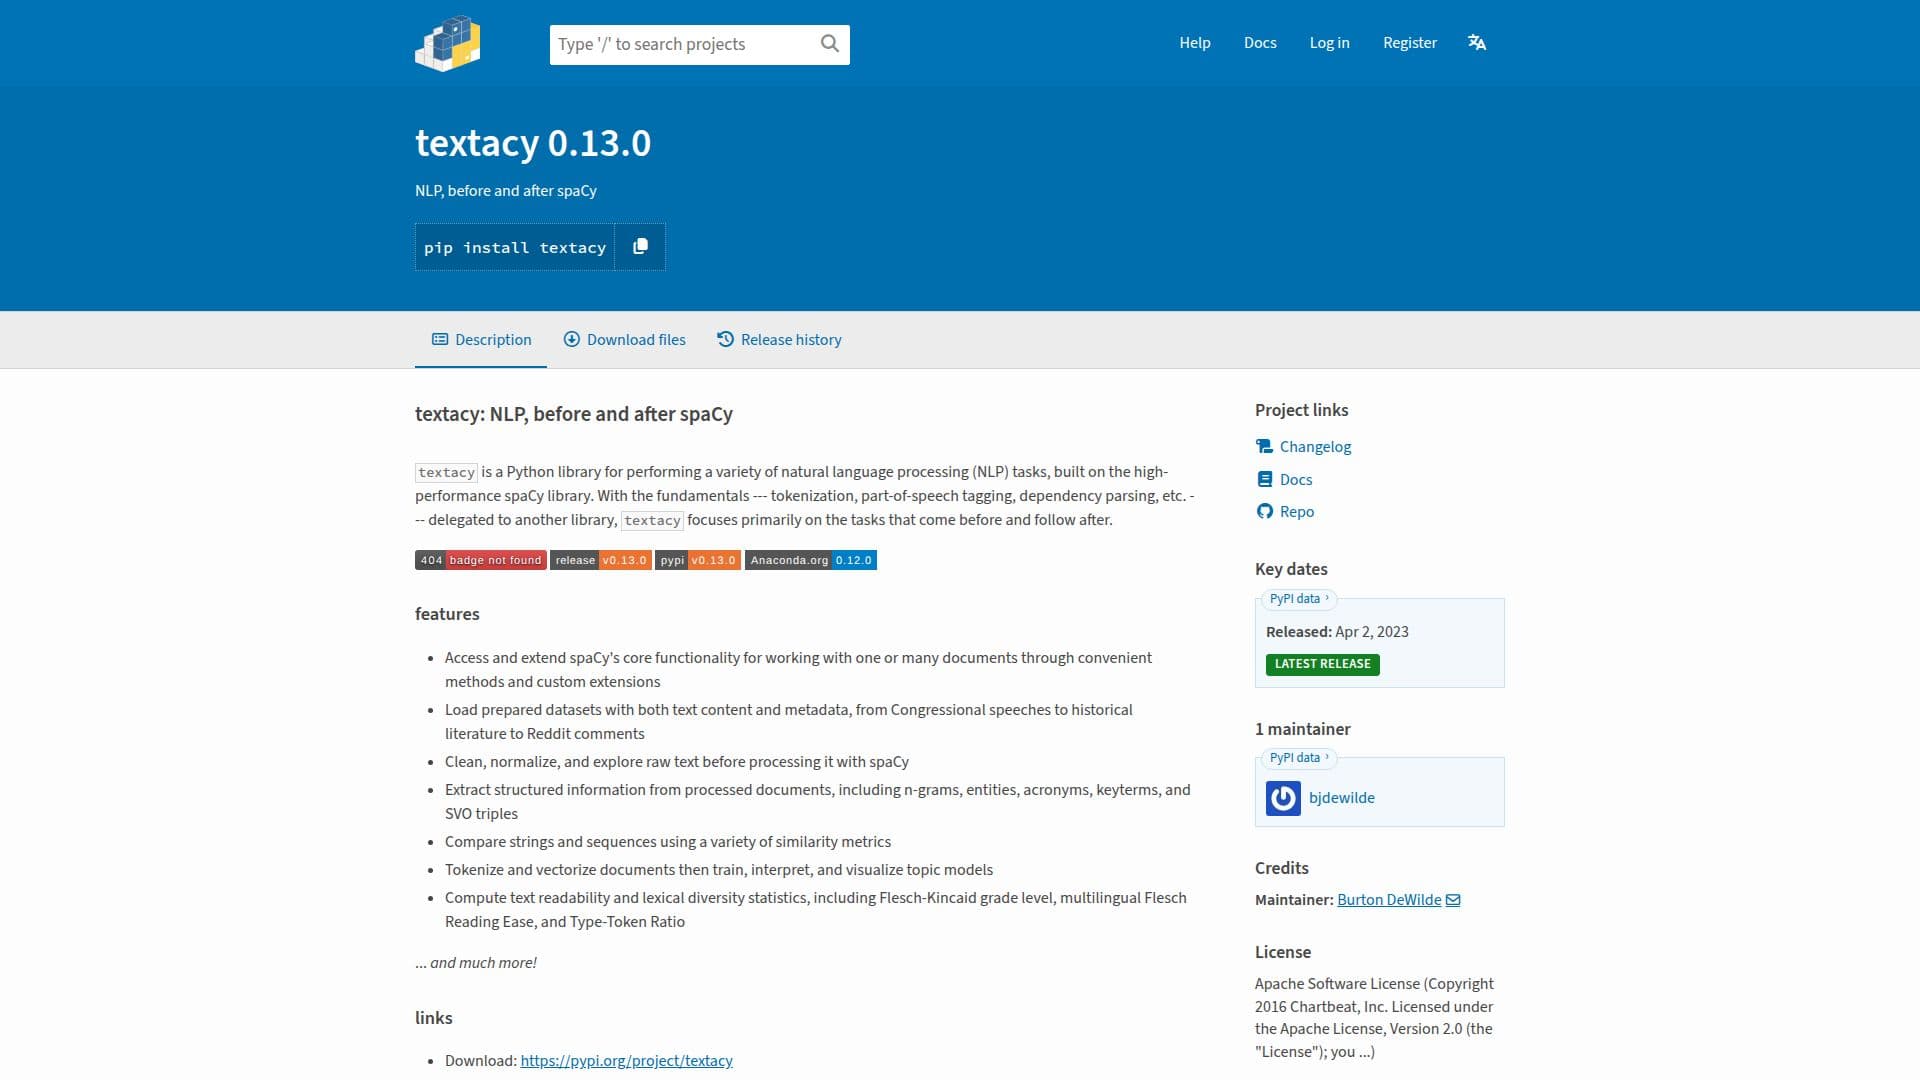
Textacy هي مكتبة بايثون مصممة لتعزيز مهام معالجة اللغة الطبيعية (NLP) من خلال البناء على قدرات spaCy. توفر مجموعة من الأدوات لمعالجة النصوص، استخراج المعلومات، والتحليل اللغوي، مما يجعلها موردًا قيمًا للمطورين والباحثين الذين يعملون مع البيانات النصية. تقدم Textacy وظائف لتطبيع النصوص، استخراج المصطلحات الرئيسية، وحساب إحصائيات النصوص. كما تتضمن وحدات لقياس تشابه الوثائق وتمثيلات الوثائق المعتمدة على الشبكات. تدعم المكتبة مجموعة من مهام معالجة اللغة الطبيعية، بما في ذلك تحديد اللغة وزيادة النصوص، وتتكامل بسلاسة مع خط أنابيب spaCy. Textacy مفتوحة المصدر ومتاحة على PyPI، مما يجعلها متاحة لمجتمع بايثون. إنها مفيدة بشكل خاص لأولئك الذين يتطلعون إلى تنفيذ مهام معالجة نصوص معقدة بكفاءة. يسمح التصميم المعياري للمكتبة للمستخدمين بتخصيص وتوسيع وظائفها لتناسب احتياجاتهم المحددة. تعزز الوثائق الشاملة والدعم النشط من المجتمع من قابلية استخدامها، حيث تقدم إرشادات وأمثلة لمختلف حالات الاستخدام. على الرغم من أنها لا تقدم واجهة مستخدم رسومية، إلا أن واجهات سطر الأوامر والبرمجة الخاصة بها قوية ومرنة، تلبي احتياجات المستخدمين المبتدئين وذوي الخبرة على حد سواء. بشكل عام، تعتبر Textacy أداة قوية لأي شخص معني بمعالجة اللغة الطبيعية، حيث تقدم ميزات متقدمة وتكامل مع spaCy لتبسيط سير عمل تحليل النصوص.
الميزات الأساسية لـ مكتبة Textacy NLP
معالجة نصوص متقدمة
استخراج المعلومات
تحليل لغوي
مقاييس تشابه الوثائق
تمثيلات الوثائق المعتمدة على الشبكات
تحديد اللغة
زيادة النصوص
تكامل مع spaCy
كيفية استخدام مكتبة Textacy NLP؟
التثبيت: استخدم pip لتثبيت Textacy من PyPI
التكامل: استورد Textacy وادمجها مع spaCy
المعالجة المسبقة: استخدم وظائف Textacy لتطبيع النصوص
الاستخراج: طبق وظائف الاستخراج للمصطلحات الرئيسية والمعلومات
حالات استخدام مكتبة Textacy NLP
- معالجة النصوص
- استخراج المعلومات
- تشابه الوثائق
- تحديد اللغة
- زيادة النصوص