الوصف
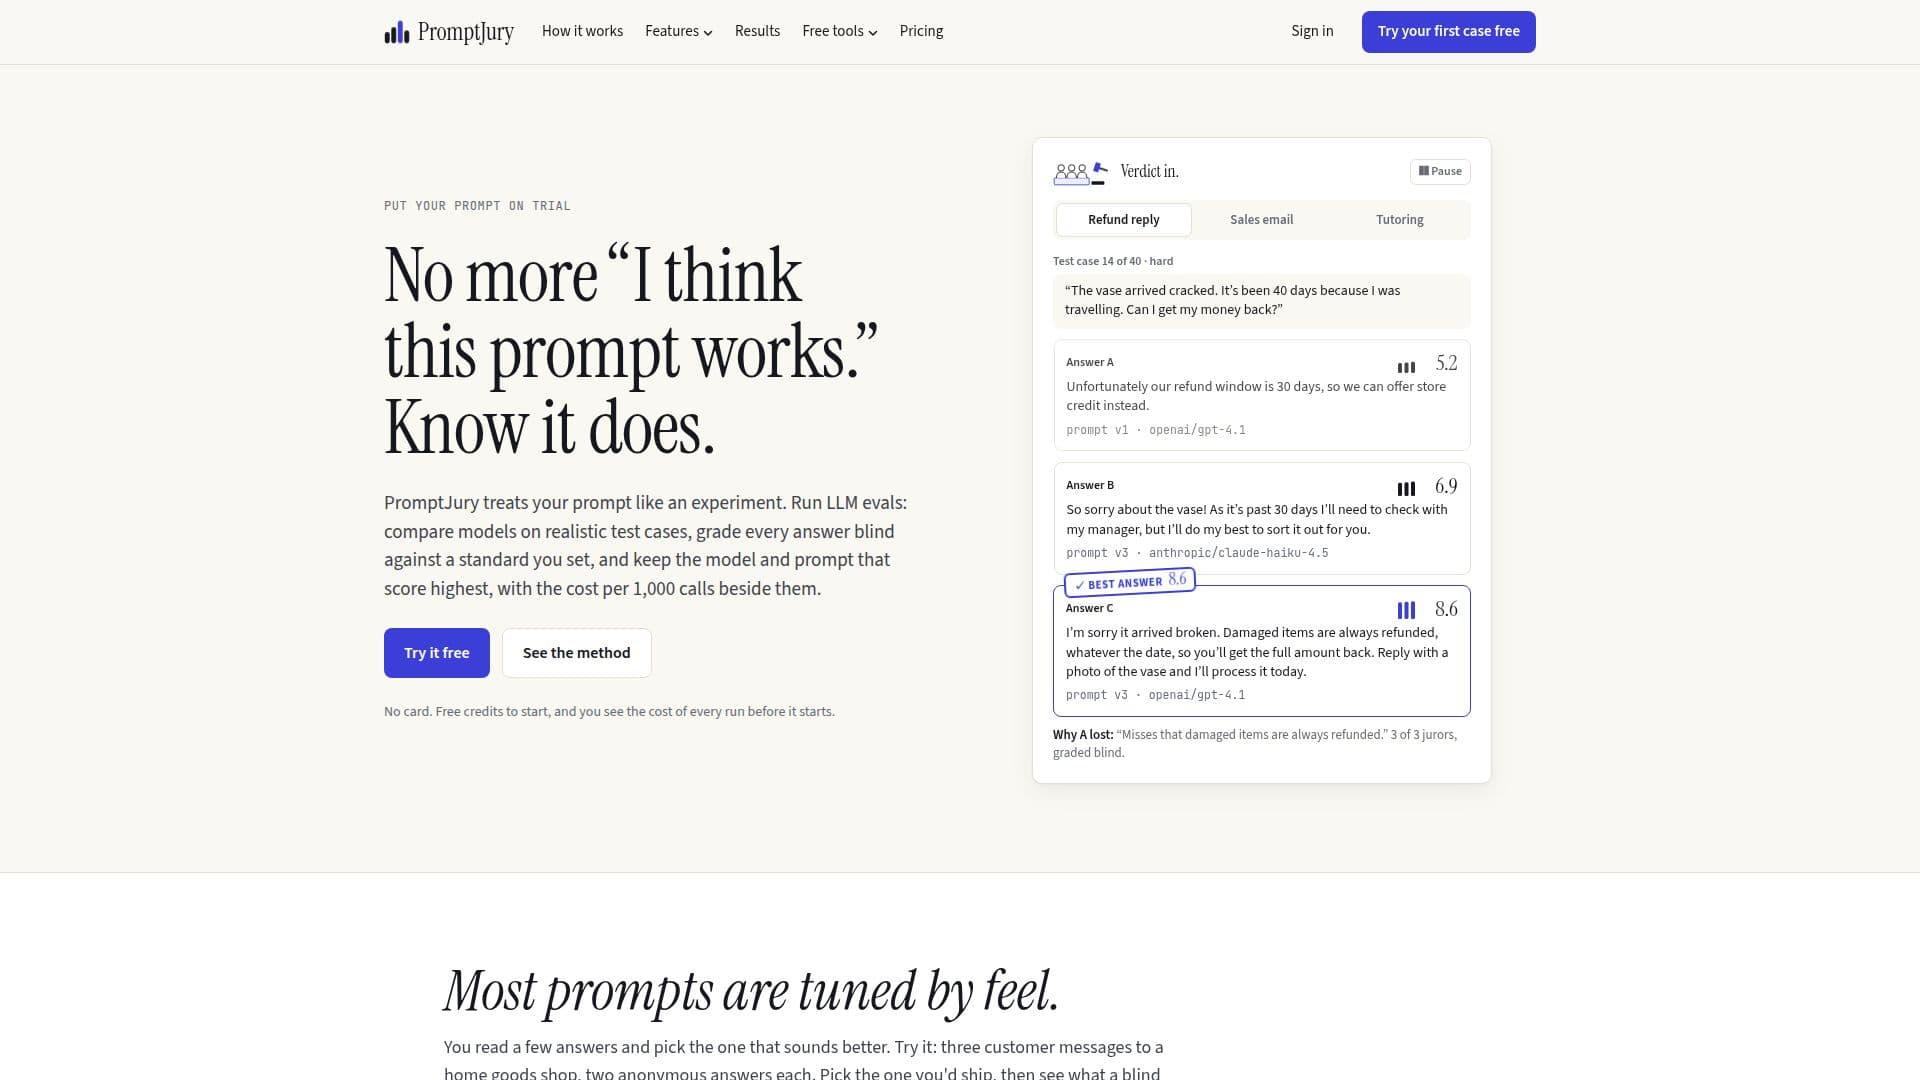
يقدم PromptJury منصة شاملة لتقييم نماذج اللغة الكبيرة (LLMs) والمحفزات، مصممة لمساعدة المستخدمين في اتخاذ قرارات مستندة إلى البيانات حول تطبيقات الذكاء الاصطناعي الخاصة بهم. تتيح الخدمة للأفراد والفرق إجراء تقييمات LLM على محفزاتهم المخصصة، ومقارنة نماذج مثل GPT وClaude وGemini على حالات اختبار مصنفة بشكل أعمى. تكشف هذه العملية عن أي تركيبات من النماذج والمحفزات تحقق أعلى الدرجات وما تكلفته، مما يوفر نهجًا علميًا لهندسة المحفزات.
قراءة المزيد
على عكس منصات التقييم التي تركز على المطورين والتي تتطلب مجموعات تطوير البرمجيات (SDKs) وتكوينات مخصصة ومجموعات اختبار مقدمة من المستخدم، يقوم PromptJury بتبسيط سير العمل الكامل للتقييم. يقوم تلقائيًا بإنشاء أدلة التقييم وحالات الاختبار، ويضع مسودات لمحفزات متنافسة، ويقوم بالتقييم العمياء باستخدام هيئة محلفين متنوعة من النماذج من صانعين مختلفين. ثم تقدم المنصة توصية واضحة، بما في ذلك المحفز الفائز، والنموذج، وتكلفته المرتبطة، كل ذلك دون الحاجة إلى أي خبرة في الترميز.
يضمن PromptJury دقة علمية في تقييماته من خلال وضع تعريف واضح لـ «الإجابة الجيدة» قبل بدء أي تقييم. يتم إخضاع كل محفز ونموذج لنفس مجموعة حالات الاختبار، ويتم إجراء التقييم بشكل أعمى. يتم تقديم كل درجة مع نطاق، مما يسمح للمستخدمين بتقييم تأثير أي تغييرات تم إجراؤها على محفزاتهم أو نماذجهم بدقة. يتناول النظام المخاوف بشأن تقييم الذكاء الاصطناعي للذكاء الاصطناعي من خلال ضمان أن معيار التقييم معتمد من المستخدم، وتقوم نماذج متعددة من صانعين مختلفين بتقييم الإجابات دون معرفة المصدر، ولا يقوم أي نموذج بتقييم مخرجاته الخاصة. يمنع متوسط الدرجة من ثلاثة مقيمين أو أكثر التحيز من محلف واحد صارم أو سخي.
يمكن للمستخدمين مقارنة أي نموذج دردشة متاح في قائمة OpenRouter الحية، بما في ذلك العروض من OpenAI وAnthropic وGoogle وxAI وDeepSeek وMistral. تساعد المنصة أيضًا في تحديد النماذج الأرخص التي تؤدي بشكل مقارب لأفضل المتنافسين، مما يوفر «اختيار القيمة» بجانب الفائز. يتضمن ذلك بيانات التكلفة لكل 1,000 مكالمة ومدخرات شهرية محتملة بناءً على أحجام المكالمات المحددة من قبل المستخدم. تتلقى الحسابات الجديدة 200 رصيدًا مجانيًا لإجراء تقييم أولي دون الحاجة إلى بطاقة ائتمان، مع بدء الخطط المدفوعة من 25 دولارًا في الشهر. لا تتطلب الخدمة مفاتيح API أو SDKs أو حساب OpenRouter، حيث تتم إدارة جميع مكالمات النماذج من خلال حساب OpenRouter الخاص بـ PromptJury ويتم دفعها باستخدام أرصدة المستخدم. تدعم المنصة المخرجات الذاتية من خلال السماح للمستخدمين بتعريف أبعاد الجودة مع أمثلة مكتوبة للتقييم. يمكن للمستخدمين أيضًا تحميل حالات اختبارهم الخاصة عبر ملفات CSV أو JSONL أو تعديل الحالات التي تم إنشاؤها بواسطة النظام. يوضح PromptJury بوضوح أنه لا يقوم بالتدريب على محفزات أو بيانات المستخدم، مما يضمن الخصوصية والتحكم في محتوى المستخدم.
- الفئةأدوات هندسة الأوامر
- نموذج التسعيرمجاني مع ميزات مدفوعة
- النشرسحابي
- المنصاتالويب
الميزات الأساسية لـ PromptJury
منصة تقييم LLM
مقارنة GPT وClaude وGemini ونماذج أخرى
حالات اختبار مصنفة بشكل أعمى
توليد حالات اختبار تلقائي
إنشاء أدلة تقييم تلقائية
مسودات لمحفزات متنافسة
عملية تقييم بدون ترميز
عرض التكلفة لكل 1,000 مكالمة
تحديد اختيار القيمة (أرخص نموذج جيد)
يدعم تقييم المخرجات الذاتية
تحميل حالات اختبار مخصصة (CSV، JSONL)
لا يتطلب مفتاح API أو SDK
لا يقوم بالتدريب على بيانات المستخدم
اختبارات انحدار مجدولة (إعادة تجارب)
تقارير حكم خاصة
كيفية استخدام PromptJury؟
وصف المهمة: حدد هدف الذكاء الاصطناعي الخاص بك وجمهوره في جملتين.
إنشاء دليل التقييم: وافق على ما تبدو عليه الإجابة الرائعة، بعد كل بُعد، مع مقياس لكل منها.
توليد محفزات متنافسة: اسمح للنماذج بكتابة محفزات متنافسة ونقد بعضها البعض وفقًا لدليل التقييم الخاص بك.
جمع حالات الاختبار: استخدم مدخلات واقعية تم إنشاؤها بواسطة النظام أو قم بتحميل ملف CSV/JSONL الخاص بك.
تشغيل التجربة العمياء: كل محفز ونموذج يجيب على كل حالة اختبار، مع لجنة منفصلة تقوم بتقييم الإجابات بشكل أعمى.
مراجعة الحكم والتحسين: احصل على أفضل محفز ونموذج، مع دليل واقتراحات لمزيد من التحسين.
حالات استخدام PromptJury
- تحسين المحفزات
- مقارنة النماذج
- ضمان الجودة
- الكفاءة من حيث التكلفة
- تقييم المخرجات الذاتية
- اختبار الانحدار
- تقارير العملاء
- تطوير ميزات الذكاء الاصطناعي