الوصف
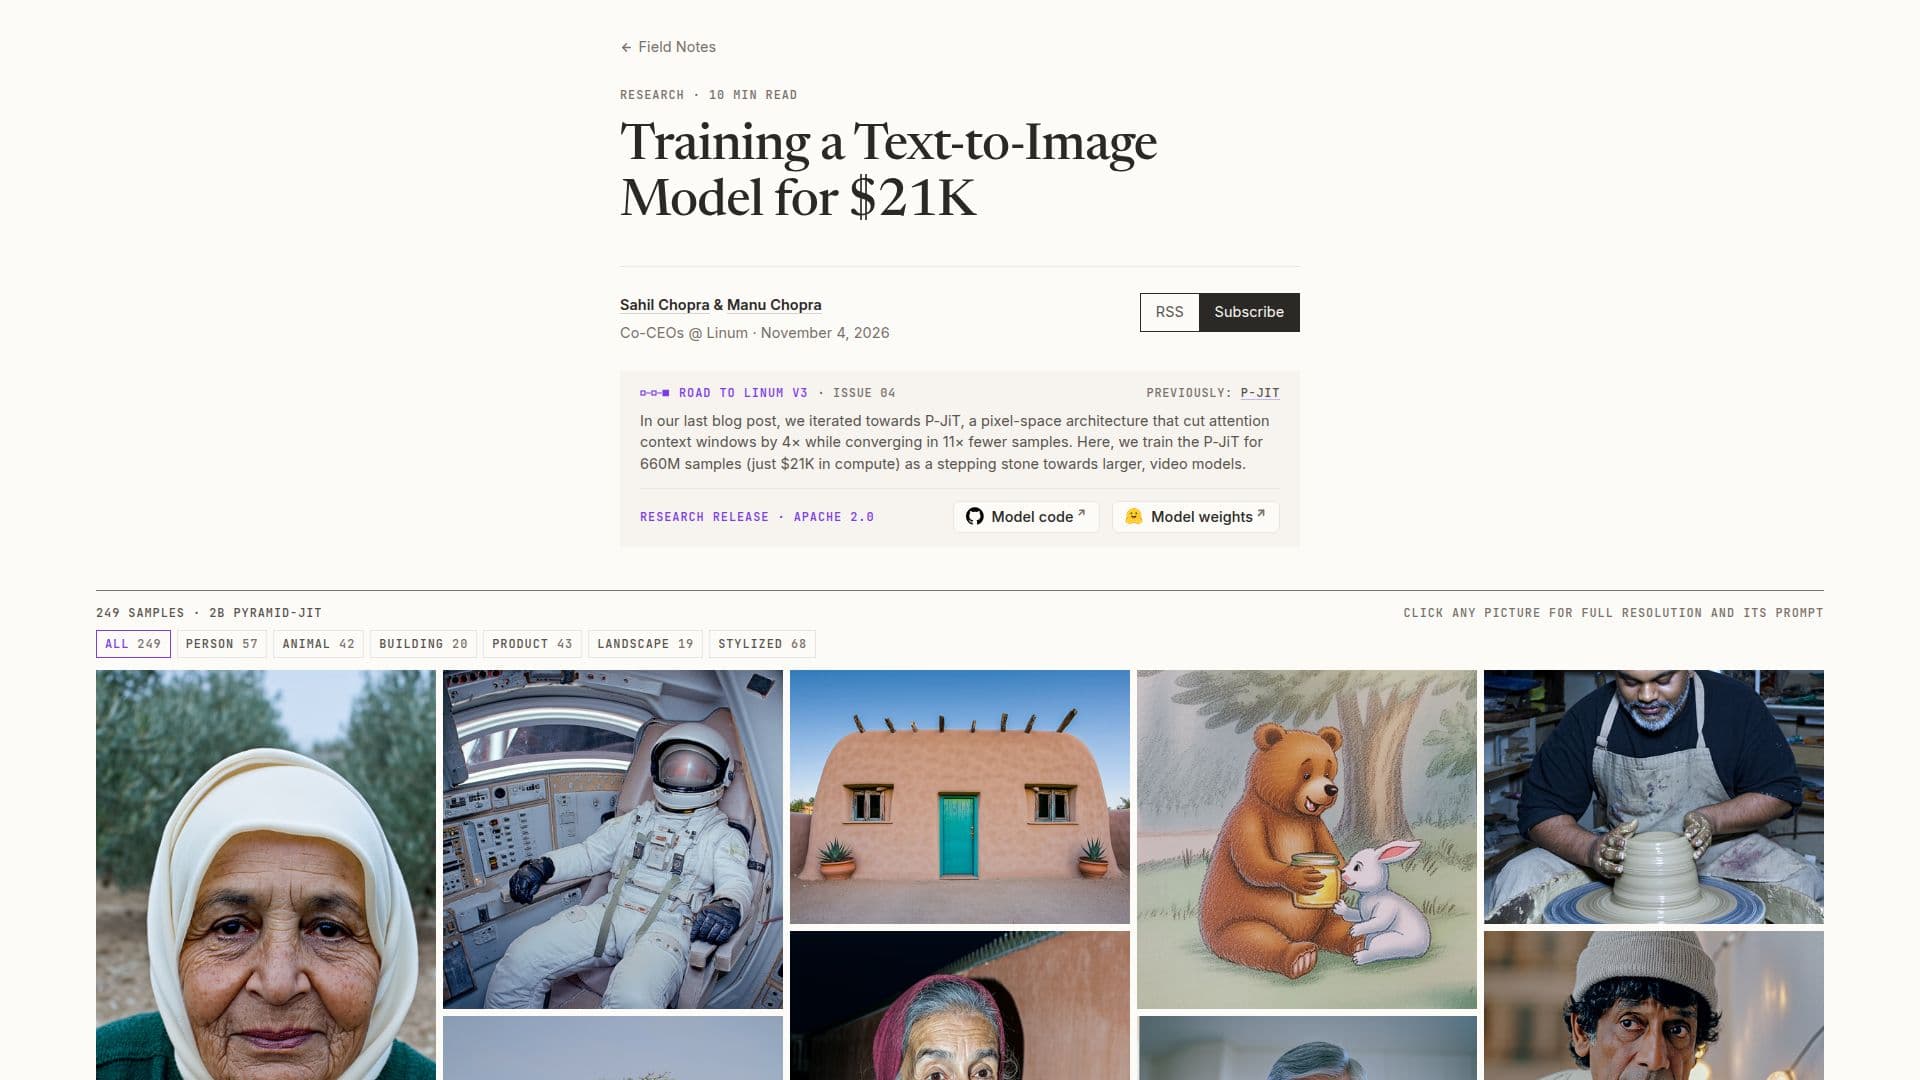
Linum P-JiT هو نموذج تجريبي لتحويل النص إلى صورة تم تطويره بواسطة Linum، وهو مختبر بحثي مكون من شخصين مخصص لتدريب نماذج الفيديو التوليدية من الصفر. هذا النموذج، الذي يحتوي على 2B من المعلمات Pyramid-JiT (P-JiT)، يعمل كدليل على المفهوم لأبحاثهم المستمرة في ديمقراطية الوصول إلى الرسوم المتحركة من خلال أدوات توليدية فعالة من حيث التكلفة وقابلة للتحكم. بلغت تكلفة تشغيل التدريب لهذا النموذج حوالي 21,038 دولار، مما يُظهر الإمكانية لتحقيق نتائج عالية الجودة بتكلفة حسابية منخفضة نسبيًا.
قراءة المزيد
الابتكار الأساسي وراء P-JiT هو قدرته على تحقيق ضغط أكثر عدوانية وتعلم أسرع من خلال القضاء على مشفر التباين التقليدي (VAE) من بنية نموذج الانتشار. بدلاً من ذلك، يتعلم نموذج الانتشار مساحة كامنة مصممة خصيصًا لحالة الاستخدام الخاصة به، مما يسمح بتحقيق ضغط أكبر وتحسين في التوليد. يتقارب هذا النموذج في مساحة البكسل في 11 مرة أقل من العينات مقارنةً بـ Linum v2 ويقدم تقليصًا أكثر عدوانية بأربع مرات، مما يمثل صورة بحجم 512x512 بنفس عدد الرموز المستخدمة سابقًا لصورة بحجم 256x256. وهذا يترجم إلى تقليص بمقدار أربعة أضعاف في نافذة سياق الانتباه، مما يقلل بشكل كبير من تكاليف التدريب والاستدلال.
تتضمن بنية P-JiT خط معالجة النص والصورة، حيث يمر كل نمط عبر كتل "مصفاة" DiT أحادية النمط قبل الدمج في تيار من 22 كتلة DiT متطابقة. يتم اشتقاق تمثيل النص من نموذج Qwen3.5-4B المجمد، بينما يتم تقسيم الصور إلى قطع بحجم 32x32 وضغطها في مساحة ذات أبعاد 1024. كما يتميز النموذج بقراءات PixelREPA المتوافقة مع DINOv3-L ورؤوس قراءة خطية إضافية على الجذع لتسريع التقارب من خلال التنبؤ بنسخ منخفضة الدقة من الصورة النهائية.
تم إجراء التدريب على مراحل متعددة، بدءًا من دقة 512x512 لـ 610 مليون عينة ثم الانتقال إلى دقة 1024x1024 لـ 50 مليون عينة. تم استخدام منهج دراسي على جدول الضوضاء، حيث تم التركيز في البداية على الضوضاء العالية لتعلم الهيكل الأساسي، ثم توسيع التوزيع للتفاصيل الدقيقة. شمل التدريب بعد ذلك نوعًا من تحسين تدفق الفرق المحدود (FDFO) مع JEV-Image وقضاة من البشر. بينما يُظهر النموذج نتائج واعدة، إلا أن لديه قيودًا، خاصة فيما يتعلق بتوليد الجسم الكامل، والكيانات المتعددة، والتفاعلات بين الأشخاص المتعددين، والمعرفة العالمية، وهي شائعة بالنسبة لنماذج بحجمه. لم يتم تدريبه باستخدام صور نصية مُعالجة، وبالتالي لا يمكنه توليد نصوص أو ملصقات.
- الفئةنماذج الذكاء الاصطناعي ونماذج اللغة الكبيرة
- نموذج التسعيرمفتوح المصدر
- النشرسحابي
- المنصاتالويب
الميزات الأساسية لـ Linum P-JiT
بنية Pyramid-JiT (P-JiT): نموذج جديد في مساحة البكسل لتوليد فعال
DiT بحجم 2B: حجم نموذج المحول الأساسي للانتشار
مشفر نص بحجم 4B: يستخدم نموذج Qwen3.5-4B المجمد لتمثيل النص
تصميم خالٍ من VAE: يقضي على VAE لتحقيق ضغط أكثر عدوانية وتعلم أسرع
تقليص الرموز بمقدار 4x: يمثل صور بحجم 512x512 مع 4x أقل من الرموز مقارنةً بـ Linum v2
تقارب أسرع بمقدار 11x: يحقق نتائج مع عدد أقل بكثير من عينات التدريب
تدريب متعدد المراحل: يتقدم من دقة 512x512 إلى 1024x1024
جدول ضوضاء منهجي: يعدل توزيع الضوضاء لتعلم الهيكل والتفاصيل
قراءات PixelREPA: ينسق المساحة الكامنة مع DINOv3-L لتحسين تعلم التفاصيل
رؤوس قراءة خطية: تتنبأ بصور نظيفة بدقة ربع ونصف لتسريع التقارب
تحسين تدفق الفرق المحدود (FDFO): يُستخدم لتحسين ما بعد التدريب
ترخيص Apache 2.0: تم إصدار الأوزان بموجب ترخيص مفتوح المصدر
تدريب فعال من حيث التكلفة: حقق نتائج عالية الجودة بتكلفة حوالي 21,000 دولار
تركيز على أبحاث الفيديو التوليدية: خطوة نحو نماذج الفيديو المستقبلية
كيفية استخدام Linum P-JiT؟
فهم البنية: مراجعة تفاصيل بنية P-JiT، بما في ذلك تدفقات معالجة النص والصورة.
فحص نظام التدريب: التعرف على عملية التدريب متعددة المراحل، وجداول الضوضاء، وانتقالات الدقة.
استكشاف قيود النموذج: فهم القيود الحالية المتعلقة بتوليد الجسم الكامل، والكيانات المتعددة، وتوليد النص.
الوصول إلى إعدادات التدريب: الرجوع إلى الملحق A للحصول على معلمات وإعدادات التدريب التفصيلية.
مراجعة تحليل التكلفة: الاطلاع على تحليل تكاليف الحوسبة قبل وبعد التدريب.
تحليل أمثلة الفشل: دراسة الأمثلة المقدمة لفشل النموذج لفهم القدرات الحالية ومجالات التحسين.
حالات استخدام Linum P-JiT
- أبحاث توليد النص إلى صورة
- تدريب نموذج فعال من حيث التكلفة
- تطوير نماذج الفيديو التوليدية
- اختبار الابتكار المعماري
- تجربة الذكاء الاصطناعي مفتوحة المصدر