الوصف
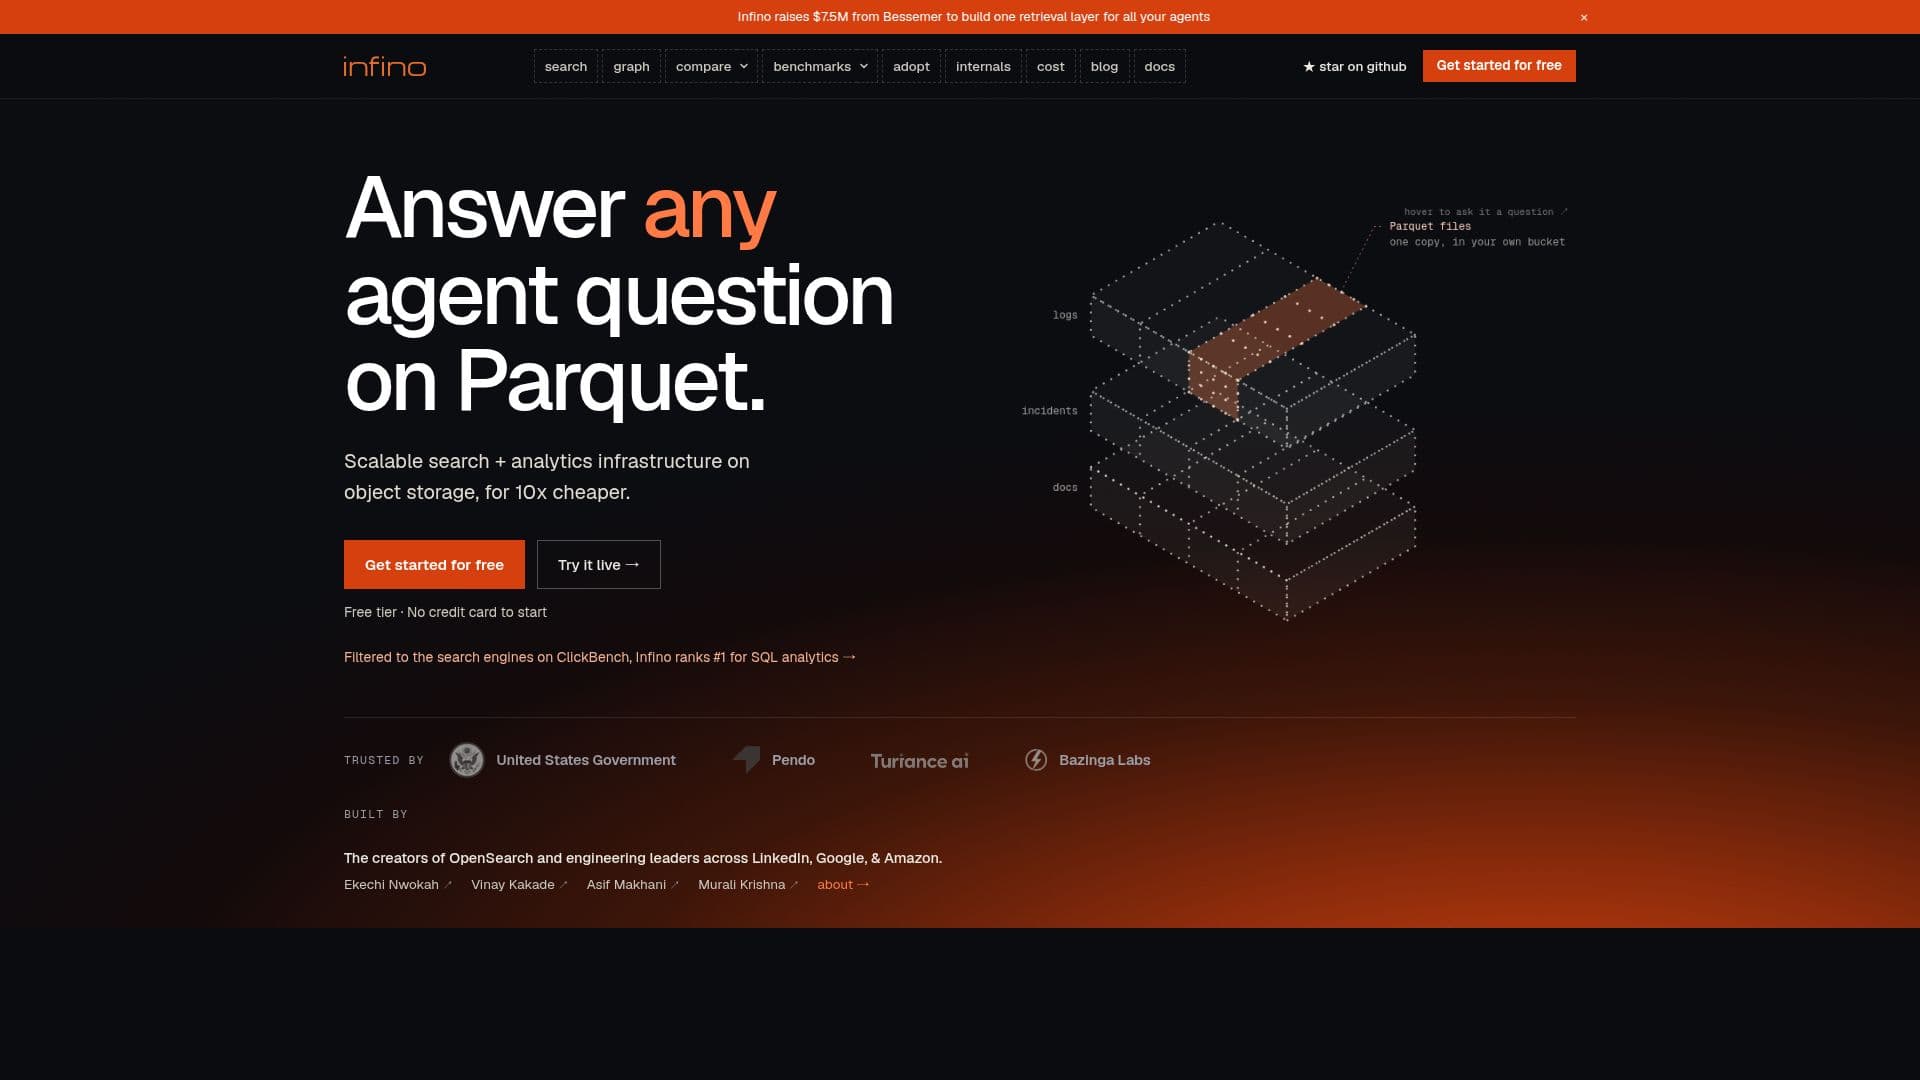
إنفينو هو محرك استرجاع مفتوح المصدر يوفر قدرات البحث النصي الكامل، والبحث بالمتجهات، وSQL بشكل أصلي على ملفات Apache Parquet المخزنة في تخزين الكائنات. تسمح هذه البنية التحتية بإنشاء بنية تحتية قابلة للتوسع للبحث والتحليلات بتكلفة أقل بكثير، وغالباً ما يُشار إليها بأنها أرخص بمقدار 10 مرات من الحلول التقليدية.
قراءة المزيد
تكمن جوهر وظيفة إنفينو في قدرته على تضمين وظائف البحث المختلفة مباشرة في استعلامات SQL. وهذا يعني أن الوكلاء الذكاء الاصطناعي يمكنهم صياغة أسئلة معقدة قد تتطلب عادةً خطوات متعددة عبر قواعد بيانات مختلفة (مثل: البحث بالكلمات الرئيسية، البحث الدلالي، البحث البياني، وتجميعات SQL) في عبارة SQL موحدة واحدة. يتولى إنفينو التعامل مع التعقيد الأساسي، وينفذ هذه الأوضاع البحثية المدمجة لتقديم نتائج استرجاع دقيقة للغاية.
يدعم المحرك أنواع بحث متعددة، بما في ذلك BM25 للبحث النصي الكامل، وHNSW وOPANN + Sq16 لفهرسة المتجهات، والبحث الهجين الذي يجمع بين هذه الطرق. كما أنه يدمج قدرات البحث البياني، مما يسمح بتحديد السجلات المرتبطة بناءً على المفاتيح المشتركة. تعزز هذه المقاربة متعددة الأوضاع دقة وكفاءة الاسترجاع.
تم تصميم إنفينو للأداء وكفاءة التكلفة، حيث يستخدم ذاكرة وموارد حسابية أقل من خلال الاحتفاظ بالبيانات على تخزين كائنات رخيصة مع الحفاظ على سرعات استعلام عالية. يقدم خيارات نشر مرنة: يمكن للمستخدمين تشغيل محرك النواة المفتوح المصدر بأنفسهم على تخزين الكائنات الخاص بهم (S3، GCS، Azure Blob، أو القرص المحلي)، أو اختيار إنفينو كلاود، وهي خدمة مُدارة بدون خادم متعددة المستأجرين. يوفر خيار المؤسسة نشرات مستأجرة فردية مع ميزات إضافية مثل استعلامات متعددة العقد ومفاتيح مُدارة من قبل العملاء.
بالنسبة لبيانات Parquet الحالية، يمكن لإنفينو بناء فهارس استرجاع من خلال عملية تُسمى الترطيب، مما يسمح للأدوات الحالية مثل DuckDB وpandas وSpark بالاستمرار في قراءة البيانات العمودية بينما يوفر إنفينو الوصول المفهرس. يجعل هذا منه حلاً تكميلياً لمنصات البيانات الحالية، قادراً على استبدال مسارات الاسترجاع المخصصة مثل Elasticsearch أو قواعد بيانات المتجهات لأحمال العمل المحددة، مع التكامل بسلاسة مع مستودعات البيانات وبيوت البحيرات.
- الفئةقواعد البيانات المتجهة والاسترجاع
- نموذج التسعيرمجاني مع ميزات مدفوعة
- النشرسحابة ، محلي ، مستضاف ذاتيًا
- المنصاتالويب
الميزات الأساسية لـ Infino
محرك استرجاع مفتوح المصدر
بحث نصي كامل (BM25)
بحث بالمتجهات (HNSW، OPANN + Sq16)
بحث هجين يجمع بين أوضاع متعددة
دعم استعلام SQL (Apache DataFusion)
تشغيل أصلي على ملفات Apache Parquet
توافق مع تخزين الكائنات (S3، GCS، Azure Blob)
قدرات البحث البياني
تضمين وظائف في SQL لاستعلامات معقدة
بنية فعالة من حيث التكلفة وقابلة للتوسع
أداء استعلامات منخفضة الكمون
خيارات نشر محلية وسحابية مستضافة
امتثال SOC 2 Type II (إنفينو كلاود)
تشفير TLS أثناء النقل وAES-256 أثناء الراحة
ترطيب البيانات لملفات Parquet الحالية
كيفية استخدام Infino؟
تثبيت إنفينو: استخدم `pip install infino` أو `npm install @infino-ai/infino` لإعداد محرك النواة المفتوح المصدر.
تخزين البيانات: احتفظ ببياناتك في تنسيق Apache Parquet داخل دلو تخزين الكائنات الخاص بك (S3، GCS، Azure Blob) أو القرص المحلي.
استيراد البيانات: أضف JSON جديدة، أو أعمدة Arrow، أو متجهات من خلال إنفينو، أو رطب ملفات Parquet الحالية لبناء فهارس الاسترجاع.
صياغة الاستعلامات: عبر عن أسئلة معقدة باستخدام عبارة SQL واحدة، مستفيداً من وظائف إنفينو المدمجة للبحث بالكلمات الرئيسية، والبحث الدلالي، والبحث البياني.
تنفيذ عمليات البحث: قم بتشغيل الاستعلامات لأداء بحث نصي كامل، أو بحث بالمتجهات، أو بحث هجين، واسترجاع النتائج المصنفة مباشرة من بيانات Parquet الخاصة بك.
تحليل النتائج: استخدم البيانات المسترجعة لتطبيقات الوكلاء أو دمجها مع قراء Parquet الآخرين مثل DuckDB وSpark وpandas لمزيد من التحليل.
حالات استخدام Infino
- الإجابة على الأسئلة الوكيلة
- استرجاع البيانات بتكلفة فعالة
- بحث وتحليلات موحدة
- تحليل السجلات والاستجابة للحوادث
- تكامل بحيرة البيانات
- البحث الدلالي على البيانات غير المنظمة
- استكشاف البيانات في الوقت الحقيقي