تخطَّ إلى المحتوى الرئيسي
ToolPotion
مستشار الذكاء الاصطناعي
إرسال (مجاني)

HoneyHive

مميزة

توفر HoneyHive طبقة مراقبة لوكلاء الذكاء الاصطناعي في بيئة الإنتاج، موحدةً المراقبة والتقييم. تُمكّن حلقات التحسين المستمر، مما يسمح للفرق بإطلاق وكلاء عاليي الجودة بثقة. توفر المنصة تتبعًا موزعًا، وتقييمًا عبر الإنترنت، وإعادة تشغيل الجلسات، وتنبيهات لمراقبة سلوك الوكيل على نطاق واسع.

زيارة الرابط
مشاركة
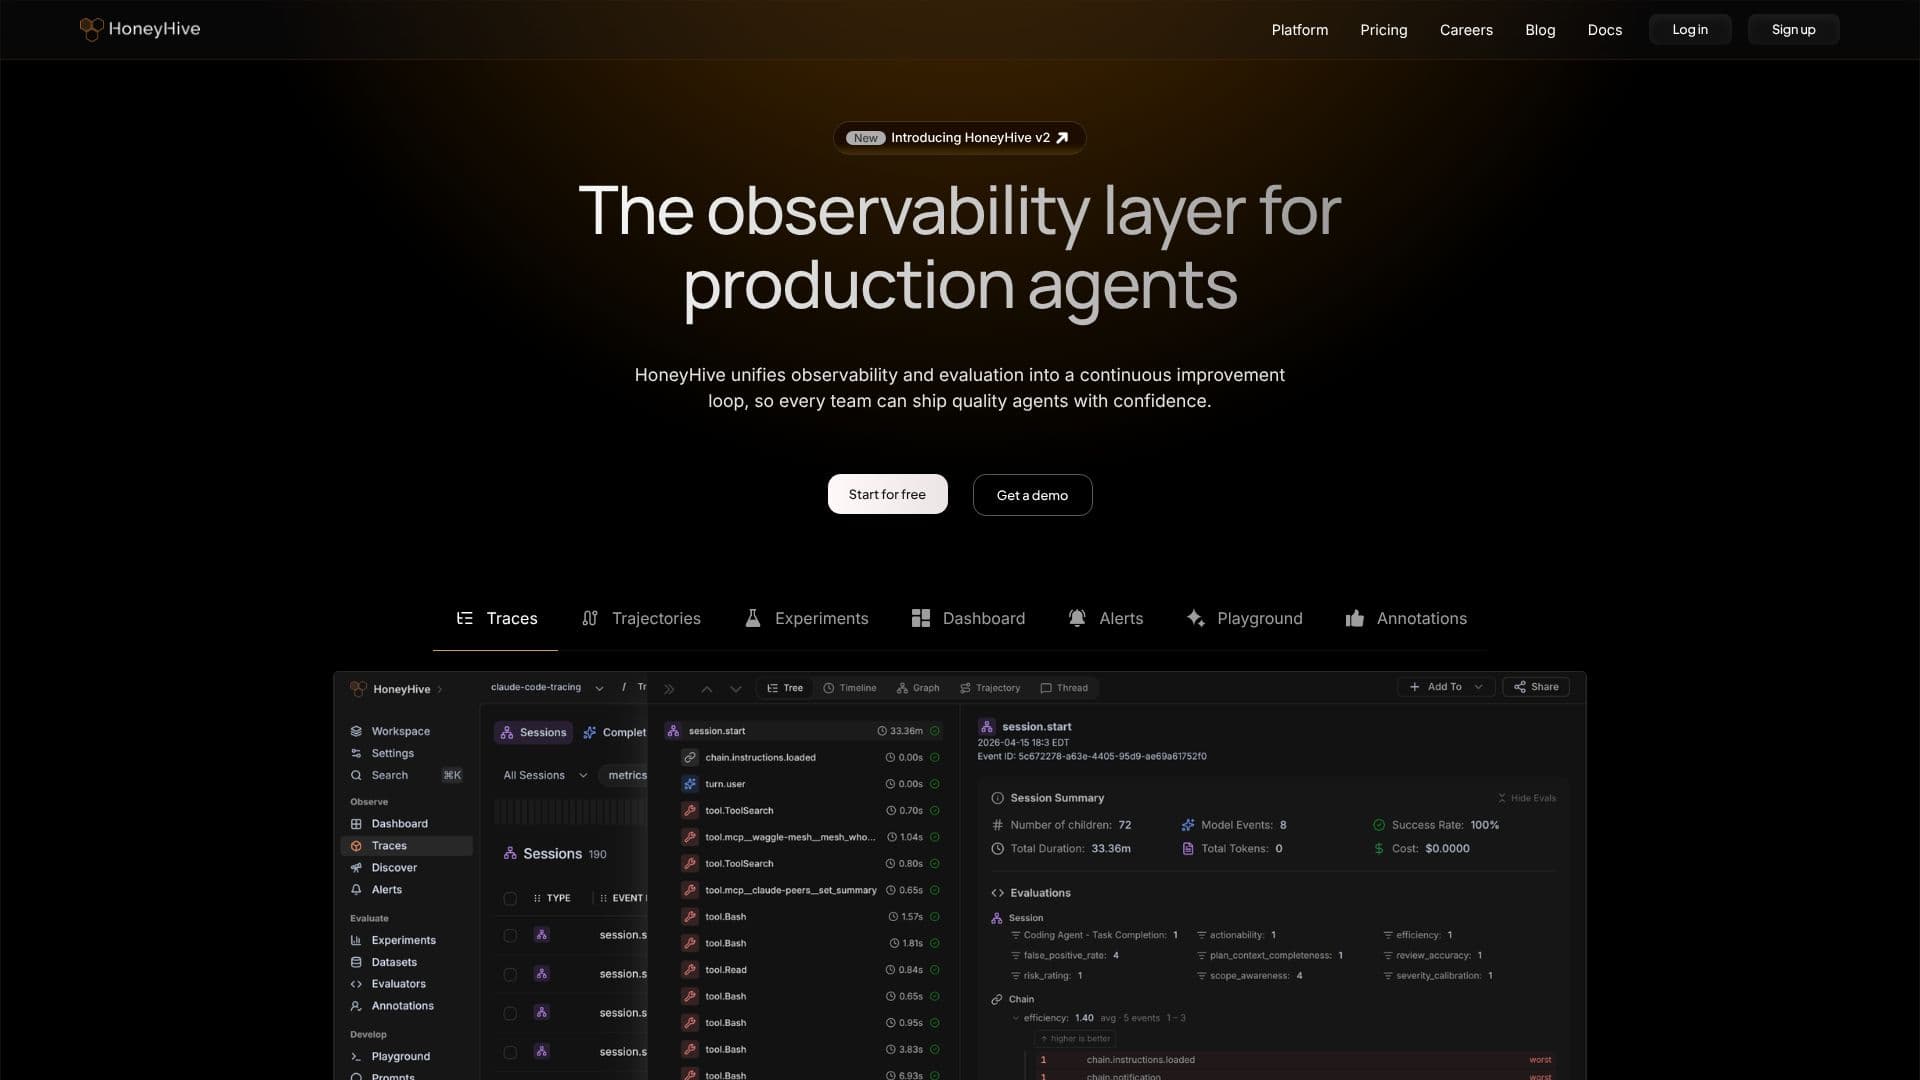
لقطة شاشة لـ HoneyHive

HoneyHive هي طبقة المراقبة المصممة لوكلاء الذكاء الاصطناعي في بيئة الإنتاج، موحدةً المراقبة والتقييم في حلقة تحسين مستمر. هذا يمكّن كل فريق في مؤسستك من إطلاق وكلاء عاليي الجودة بثقة. توفر المنصة مجموعة شاملة من الأدوات لفهم أداء وكلاء الذكاء الاصطناعي وتصحيح الأخطاء وتحسينه.

قراءة المزيد

في جوهرها، توفر HoneyHive إمكانيات التتبع الموزع، مما يسمح لك بالاطلاع على أي وكيل، على أي إطار عمل، في أي مكان. من خلال تجهيز الوكلاء بـ OpenTelemetry، فإنها تنشئ مصدرًا مشتركًا للحقيقة لتصحيح سلوك الوكيل، وتعمل عبر أكثر من 100 نموذج لغوي كبير (LLM) وإطارات عمل الوكلاء. تتيح ميزات التقييم عبر الإنترنت الكشف المباشر عن حالات الفشل عبر الوكلاء، بينما تسمح إعادة تشغيل الجلسات في Playground بمراجعة مفصلة لتفاعلات الدردشة. تساعد طرق العرض المتقدمة للتصفية والتجميع والرسم البياني والجدول الزمني في تصحيح الأنظمة المعقدة متعددة الوكلاء، ويكملها التقاط ملاحظات المستخدم للإشارات الضمنية والصريحة.

تتم إدارة المراقبة والتنبيهات باستمرار على نطاق واسع. تقوم HoneyHive بتقييم التتبعات المباشرة، ومراقبة ملاحظات المستخدم في العالم الحقيقي، وتنبيه على أوضاع الفشل الحرجة. يمكن للتقييم عبر الإنترنت الاستفادة من LLM-as-a-judge أو التعليمات البرمجية المخصصة. تحدد التنبيهات واكتشاف الانحراف بشكل استباقي حالات فشل الوكيل قبل أن يكتشفها المستخدمون، مع أتمتة لإضافة المطالبات الفاشلة إلى مجموعات البيانات أو تشغيل مراجعة بشرية. توفر لوحات المعلومات المخصصة رؤى سريعة حول المقاييس الرئيسية، وتساعد تحليلات الاستكشاف في اكتشاف الأنماط عبر ملايين التتبعات. يتم تعزيز تحليل السبب الجذري باستخدام الذكاء الاصطناعي، مما يمنح وكلاء الترميز سياقًا لإصلاح المشكلات.

يتم تعزيز الثقة في إطلاق التغييرات من خلال التقييمات غير المتصلة بالإنترنت. يمكن تحويل حالات فشل الإنتاج إلى مجموعات اختبار، ومقارنة التغييرات الجديدة بخطوط الأساس، واكتشاف الانحدارات قبل كل إصدار. تسمح التجارب بالاختبار غير المتصل بالإنترنت مقابل مجموعات بيانات كبيرة، مع إدارة مركزية لمجموعات البيانات ومقيمين مخصصين. يتم تسهيل المراجعة البشرية من قبل خبراء المجال، ويكتشف اكتشاف الانحدار المشكلات الحرجة أثناء التكرار. يتيح التكامل مع CI/CD مجموعات اختبار آلية لكل التزام.

يتم تحقيق جودة تشكيل الوكيل من خلال قوائم الانتظار للتعليقات التوضيحية، وإشراك خبراء المجال لمراجعة الحالات الهامشية وتحديد الجودة. تقوم أتمتة قوائم الانتظار بتوجيه التتبعات المميزة إلى المراجعين المناسبين، ويتم إجراء المراجعة البشرية في واجهة سهلة الاستخدام. تقوم المعايير المخصصة بتوحيد المراجعة بمعايير خاصة بالعمل، ويوفر تنسيق مجموعة البيانات إصدارًا يعتمد على Git. يلتقط مسار التدقيق ملاحظات الخبراء جنبًا إلى جنب مع سياق التتبع، ويستخدم محاذاة المقيم الملاحظات لتحسين مقيمي LLM مع خبراء الموضوع.

تم بناء HoneyHive على معايير مفتوحة ونظام بيئي مفتوح، وهي OpenTelemetry-native ومستقلة عن إطار العمل. تتكامل مع أي نموذج أو إطار عمل أو وقت تشغيل وكيل يدعم تجهيز OTel. تم تصميمها لتكون قابلة للتوسع وتوفر الخصوصية افتراضيًا، وهي تتعامل مع إدخال/إخراج تتبع الذكاء الاصطناعي الحساس. تثق شركات Fortune 500 في HoneyHive لتوسيع نطاق وكلاء الذكاء الاصطناعي بمسؤولية. توفر المنصة مستويات بيانات افتراضية للعزل المنطقي، مع خيارات نشر SaaS و Hybrid و Self-hosted. تشمل ميزات الأمان التحكم في الوصول المستند إلى الأدوار (RBAC) بشكل دقيق، وتكامل SSO و SAML، والامتثال لـ SOC 2 و GDPR و HIPAA. يضمن تسجيل التدقيق إمكانية تتبع كل إجراء.

  • الفئةMLOps ونشر النماذج
  • نموذج التسعيرتوجد باقة مجانية
  • النشرSaaS، هجين، مستضاف ذاتيًا
  • المنصاتالويب

  • التتبع الموزع لوكلاء الذكاء الاصطناعي

  • التجهيز بـ OpenTelemetry-native

  • التقييم عبر الإنترنت مع LLM-as-a-Judge

  • إعادة تشغيل الجلسة و Playground

  • المراقبة والتنبيه على فشل الوكيل

  • اكتشاف الانحراف لنماذج الذكاء الاصطناعي

  • تجارب غير متصلة بالإنترنت واختبار الانحدار

  • التكامل مع CI/CD لوكلاء الذكاء الاصطناعي

  • قوائم انتظار المراجعة البشرية والتعليقات التوضيحية

  • معايير مخصصة لتحديد الجودة

  • تنسيق مجموعة البيانات وإصدارها

  • تحليل السبب الجذري المدعوم بالذكاء الاصطناعي

  • التحكم الدقيق في الوصول المستند إلى الأدوار (RBAC)

  • تكامل SSO و SAML

  • الامتثال لـ SOC 2 و GDPR و HIPAA

  1. التجهيز: قم بدمج OpenTelemetry في وكلاء الذكاء الاصطناعي وإطارات العمل الخاصة بك.

  2. المراقبة: استخدم التتبع الموزع لمراقبة سلوك الوكيل في الوقت الفعلي.

  3. التقييم: قم بإجراء تقييمات عبر الإنترنت وغير متصلة بالإنترنت للكشف عن حالات الفشل وتحليلها.

  4. التنبيه: قم بتكوين تنبيهات لأوضاع الفشل الحرجة واكتشاف الانحراف.

  5. التحسين: استخدم إعادة تشغيل الجلسات والمراجعة البشرية لتحسين جودة الوكيل.

  6. الأتمتة: استفد من التكامل مع CI/CD للاختبار والنشر المستمر.

  7. التحليل: استخدم تحليل السبب الجذري المدعوم بالذكاء الاصطناعي لحل المشكلات.

  • تصحيح أخطاء الوكيل
  • مراقبة الأداء
  • ضمان الجودة
  • التحسين المستمر
  • اختبار الانحدار
  • تصحيح أخطاء أنظمة الوكلاء المتعددة
  • تكامل ملاحظات المستخدم
  • تحليل السبب الجذري الآلي

تقييمات HoneyHive

جاري التحميل...

أدوات ذكاء اصطناعي شائعة مثل HoneyHive

Latitude

تطبيقات الذكاء الاصطناعي

منصة مفتوحة المصدر لرصد ومراقبة وكلاء الذكاء الاصطناعي تتعقب الوكلاء في الإنتاج، وتظهر الأخطاء، وتقوم بإرسال وكلاء برمجيين لإصلاحها تلقائيًا.

MLOps ونشر النماذج

المرتبة 35 في أدوات هندسة الأوامر

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة مفتوحة المصدر لرصد ومراقبة وكلاء الذكاء الاصطناعي تتعقب الوكلاء في الإنتاج، وتظهر الأخطاء، وتقوم بإرسال وكلاء برمجيين لإصلاحها تلقائيًا.

مميزةMLOps ونشر النماذج
المرتبة 35 في أدوات هندسة الأوامر

LangWatch

تطبيقات الذكاء الاصطناعي

LangWatch هي منصة لاختبار وكلاء الذكاء الاصطناعي، وتقييم نماذج اللغة الكبيرة (LLMs)، والمراقبة. تسمح للمطورين بمحاكاة سيناريوهات العالم الحقيقي، ومنع التراجعات، وتصحيح الأخطاء عن…

MLOps ونشر النماذج

المرتبة 13 في أدوات هندسة الأوامر

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة لاختبار وكلاء الذكاء الاصطناعي، وتقييم نماذج اللغة الكبيرة (LLMs)، والمراقبة. تسمح للمطورين بمحاكاة سيناريوهات العالم الحقيقي، ومنع التراجعات، وتصحيح الأخطاء عن…LangWatch هي منصة لاختبار وكلاء الذكاء الاصطناعي، وتقييم نماذج اللغة الكبيرة (LLMs)، والمراقبة. تسمح للمطورين بمحاكاة سيناريوهات العالم الحقيقي، ومنع التراجعات، وتصحيح الأخطاء عن…

مميزةMLOps ونشر النماذج
المرتبة 13 في أدوات هندسة الأوامر

Future AGI

تطبيقات الذكاء الاصطناعي

Future AGI هي منصة مفتوحة المصدر لبناء واختبار ومراقبة وكلاء الذكاء الاصطناعي. تساعد في اكتشاف وتصحيح هلوسات الذكاء الاصطناعي في الوقت الفعلي باستخدام حواجز الحماية، وتقييمات…

MLOps ونشر النماذج

المرتبة 44 في MLOps ونشر النماذج

عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة مفتوحة المصدر لبناء واختبار ومراقبة وكلاء الذكاء الاصطناعي. تساعد في اكتشاف وتصحيح هلوسات الذكاء الاصطناعي في الوقت الفعلي باستخدام حواجز الحماية، وتقييمات…Future AGI هي منصة مفتوحة المصدر لبناء واختبار ومراقبة وكلاء الذكاء الاصطناعي. تساعد في اكتشاف وتصحيح هلوسات الذكاء الاصطناعي في الوقت الفعلي باستخدام حواجز الحماية، وتقييمات…

مميزةMLOps ونشر النماذج
المرتبة 44 في MLOps ونشر النماذج

LangSmith: رؤية وكلاء الذكاء الاصطناعي

منصات الذكاء الاصطناعي

LangSmith عبارة عن منصة رؤية لوكلاء الذكاء الاصطناعي ونماذج اللغات الكبيرة (LLM) توفر رؤية كاملة لسلوك الوكيل. تساعد في تصحيح أخطاء الوكلاء، وتحديد حالات الفشل، وتتبع التكاليف…

MLOps ونشر النماذج

المرتبة 35 في منصات الذكاء الاصطناعي

عرض الأداة

منصات الذكاء الاصطناعي

منصة رؤية لوكلاء الذكاء الاصطناعي ونماذج اللغات الكبيرة (LLM) توفر رؤية كاملة لسلوك الوكيل. تساعد في تصحيح أخطاء الوكلاء، وتحديد حالات الفشل، وتتبع التكاليف…LangSmith عبارة عن منصة رؤية لوكلاء الذكاء الاصطناعي ونماذج اللغات الكبيرة (LLM) توفر رؤية كاملة لسلوك الوكيل. تساعد في تصحيح أخطاء الوكلاء، وتحديد حالات الفشل، وتتبع التكاليف…

مميزةMLOps ونشر النماذج
المرتبة 35 في منصات الذكاء الاصطناعي

Phoenix - Arize AI

تطبيقات الذكاء الاصطناعي

Arize Phoenix هي منصة مفتوحة المصدر لتطوير الذكاء الاصطناعي مصممة لتطوير وتقييم الوكلاء. توفر أدوات لتتبع وقياس وتحسين جودة الوكلاء الذكاء الاصطناعي، مما يجعلها مناسبة لمهندسي…

MLOps ونشر النماذج
عرض الأداة

تطبيقات الذكاء الاصطناعي

Arize Phoenix هي منصة مفتوحة المصدر لتطوير الذكاء الاصطناعي مصممة لتطوير وتقييم الوكلاء. توفر أدوات لتتبع وقياس وتحسين جودة الوكلاء الذكاء الاصطناعي، مما يجعلها مناسبة لمهندسي…

MLOps ونشر النماذج
عرض أفضل 250 من تطبيقات الذكاء الاصطناعي

Opik بواسطة كوميت

تطبيقات الذكاء الاصطناعي

Opik هي منصة مفتوحة المصدر لرصد الذكاء الاصطناعي تساعد المطورين في اختبار وتوزيع وتحسين الأنظمة الوكيلة بشكل مستمر. توفر أدوات لتقييم ومراقبة تطبيقات نماذج اللغة الكبيرة (LLM)…

MLOps ونشر النماذج
عرض الأداة

تطبيقات الذكاء الاصطناعي

منصة مفتوحة المصدر لرصد الذكاء الاصطناعي تساعد المطورين في اختبار وتوزيع وتحسين الأنظمة الوكيلة بشكل مستمر. توفر أدوات لتقييم ومراقبة تطبيقات نماذج اللغة الكبيرة (LLM)…Opik هي منصة مفتوحة المصدر لرصد الذكاء الاصطناعي تساعد المطورين في اختبار وتوزيع وتحسين الأنظمة الوكيلة بشكل مستمر. توفر أدوات لتقييم ومراقبة تطبيقات نماذج اللغة الكبيرة (LLM)…

MLOps ونشر النماذج
عرض أفضل 250 من تطبيقات الذكاء الاصطناعي

AgentOps

منصات الذكاء الاصطناعي

يوفر AgentOps منصة لتتبع وتصحيح الأخطاء ونشر وكلاء الذكاء الاصطناعي الموثوقين. يقدم إعادة تشغيل الجلسات، وتصحيح الأخطاء بالسفر عبر الزمن، ومسار بيانات كامل للسجلات والأخطاء، مما…

MLOps ونشر النماذج

المرتبة 99 في منصات الذكاء الاصطناعي

عرض الأداة

منصات الذكاء الاصطناعي

يوفر AgentOps منصة لتتبع وتصحيح الأخطاء ونشر وكلاء الذكاء الاصطناعي الموثوقين. يقدم إعادة تشغيل الجلسات، وتصحيح الأخطاء بالسفر عبر الزمن، ومسار بيانات كامل للسجلات والأخطاء، مما…

MLOps ونشر النماذج
المرتبة 99 في منصات الذكاء الاصطناعي

Chirpz AI

تطبيقات الذكاء الاصطناعي

Chirpz AI هو مختبر للذكاء الاصطناعي التطبيقي يركز على هندسة الوكلاء. منتجه، PandaProbe، هو منصة مفتوحة المصدر لتتبع وتقييم ومراقبة الوكلاء الذكاء الاصطناعي حتى تتمكن الفرق من…

MLOps ونشر النماذج
عرض الأداة

تطبيقات الذكاء الاصطناعي

مختبر للذكاء الاصطناعي التطبيقي يركز على هندسة الوكلاء. منتجه، PandaProbe، هو منصة مفتوحة المصدر لتتبع وتقييم ومراقبة الوكلاء الذكاء الاصطناعي حتى تتمكن الفرق من…Chirpz AI هو مختبر للذكاء الاصطناعي التطبيقي يركز على هندسة الوكلاء. منتجه، PandaProbe، هو منصة مفتوحة المصدر لتتبع وتقييم ومراقبة الوكلاء الذكاء الاصطناعي حتى تتمكن الفرق من…

MLOps ونشر النماذج
عرض أفضل 250 من تطبيقات الذكاء الاصطناعي
1 من 8