الوصف
Flide هي بنية تحتية متقدمة للاستدلال مصممة خصيصًا لتسريع نماذج القرار بأسلوب Jev. تكمن ابتكاراتها الأساسية في قدرتها على تنفيذ تقسيم الحالة بدقة، مما يسمح بمعالجة حالة إدخال واحدة لعدة أسئلة في تمريرة واحدة للأمام. وهذا يعني أن الحالة تُقرأ مرة واحدة فقط، ثم تُقسم بكفاءة، مما يضمن أن كل سؤال يتلقى الإجابة الدقيقة التي سيحصل عليها إذا تم طرحه في عزلة.
قراءة المزيد
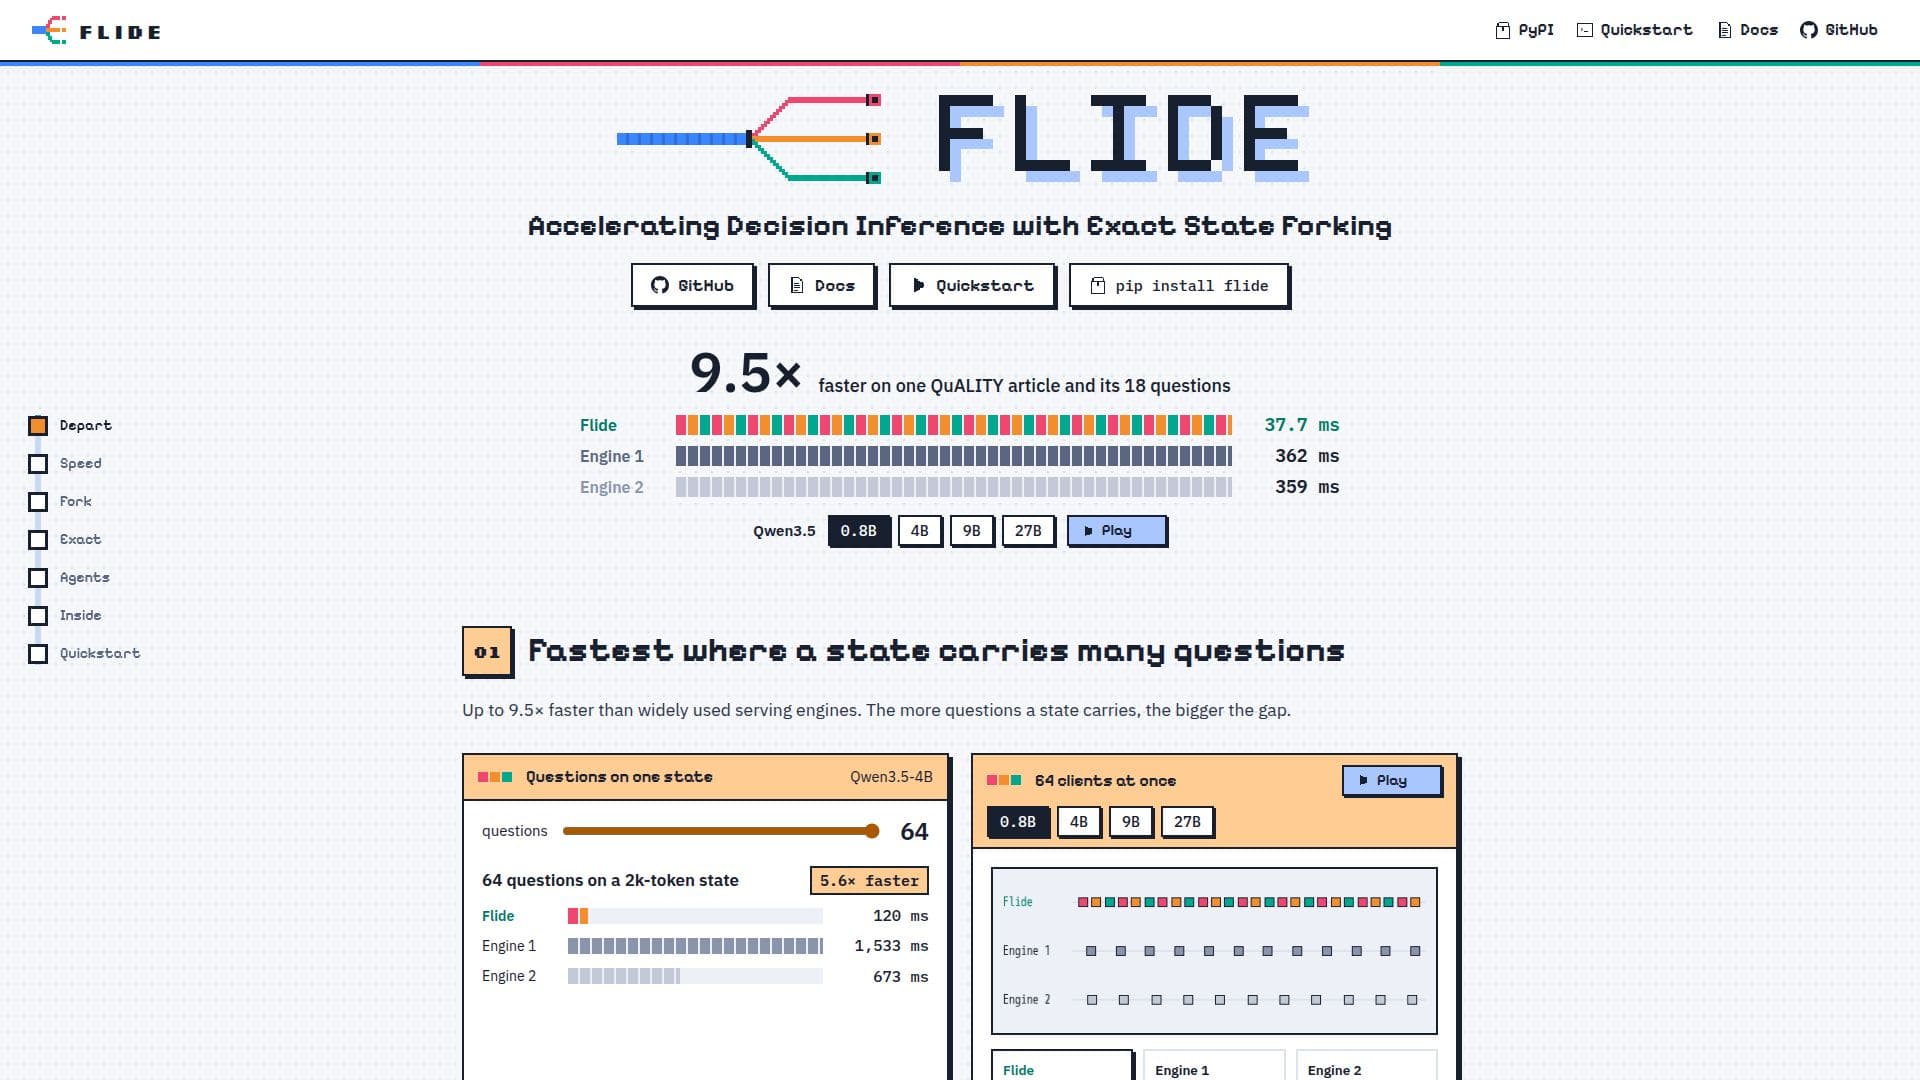
توفر هذه الهندسة المعمارية الفريدة مكاسب كبيرة في الأداء، حيث تُظهر Flide استدلالًا أسرع حتى 9.5 مرات مقارنة بمحركات الخدمة المستخدمة على نطاق واسع مثل vLLM و SGLang. تصبح ميزة الأداء أكثر وضوحًا مع زيادة عدد الأسئلة المرتبطة بحالة معينة. على سبيل المثال، مع 64 سؤالًا على حالة مكونة من 2000 توكن، تحقق Flide تسريعًا بمعدل 9.5x وإنتاجية أعلى بمعدل 2.2x مع 64 عميلًا.
بعيدًا عن السرعة، تعطي Flide الأولوية للدقة، حيث تبقى ضمن 1.1 نقطة من مرجع float32، مما يجعلها واحدة من أقرب المحركات إلى مرجع الحقيقة الأساسية. تدعم مجموعة متنوعة من النماذج، بما في ذلك نماذج الدردشة المستندة إلى Qwen3.5 و Gemma 4، بالإضافة إلى نماذج OneJev. تتعامل Flide أيضًا مع النماذج الهجينة، حيث تضمن طبقات Gated DeltaNet أن يبدأ كل سؤال من الحالة الدقيقة للسياق المشترك. يقدم النظام خيار `--batch-invariant`، مما يضمن أن الطلب ينتج نفس البتات بغض النظر عن كيفية تجميعه.
تثبيت Flide سهل عبر pip، ويدعم الخدمة مع نوى مسبقة البناء لمجموعة متنوعة من وحدات معالجة الرسوميات NVIDIA، بما في ذلك A40 و A10 و RTX 30 و H100 و H200. تعرض Flide نفس واجهة برمجة التطبيقات `/v1/systemone` مثل vLLM و SGLang، مما يوفر احتمالات لكل خيار في الإجابة. تدعم المدخلات متعددة الوسائط، بما في ذلك النصوص والصور والفيديو، اعتمادًا على نموذج العمود الفقري. تعزز ميزات مثل تقليل FP8 لـ Qwen3.5 على وحدات معالجة الرسوميات Ada و Hopper و Blackwell، وذاكرة التخزين المؤقت للجلسة لاستئناف حالات الوكلاء، قدراتها بشكل أكبر.
- الفئةMLOps ونشر النماذج
- النشرمستضاف ذاتيًا
- المنصاتالويب
الميزات الأساسية لـ Flide
تقسيم الحالة بدقة: يعالج حالة واحدة لجميع الأسئلة في تمريرة واحدة للأمام.
استدلال معزز: أسرع حتى 9.5 مرات من محركات الخدمة الأخرى.
إنتاجية عالية: تحقق إنتاجية أعلى بمعدل 2.2x مع 64 عميلًا في معايير محددة.
قرب مرجع Float32: تبقى ضمن 1.1 نقطة من مرجع float32 للدقة.
ثبات التجميع: يضمن نتائج متسقة بغض النظر عن التجميع مع `--batch-invariant`.
آلية ForkAttention: كل سؤال يقرأ حالته في مكانه، كما لو تم طرحه بمفرده.
دقة في النماذج الهجينة: تدعم طبقات Gated DeltaNet لمعالجة السياق بدقة.
معالجة تدفق مسطح واحد: يشغل الطلبات كتيار توكن واحد يتم إعادة تشغيله بواسطة رسوم CUDA.
واجهة برمجة التطبيقات المتوافقة مع vLLM/SGLang: تستخدم معيار واجهة برمجة التطبيقات `/v1/systemone`.
نوى مسبقة البناء: محسّنة لوحدات معالجة الرسوميات NVIDIA A40 و A10 و RTX 30 و H100 و H200.
نموذج العمود الفقري: تدعم Qwen3.5 (0.8B، 2B، 4B، 9B، 27B) و Gemma 4 (E2B، E4B، 12B، 26B-A4B، 31B).
مدخلات متعددة الوسائط: تتعامل مع مدخلات النصوص والصور والفيديو.
تقليل FP8: يشغل Qwen3.5 في FP8 على وحدات معالجة الرسوميات Ada و Hopper و Blackwell.
ذاكرة التخزين المؤقت للجلسة: تحتفظ بالحالات السابقة لوكلاء لاستئنافها (مثل `--session-cache-gb 40`).
عمليات الواجهة الأمامية: تدعم تشغيل HTTP، والتقديم، والتجزئة في عمليات منفصلة للعديد من العملاء.
كيفية استخدام Flide؟
تثبيت Flide: استخدم pip لتثبيت حزمة Flide.
بدء خادم: قم بتشغيل `flide serve` لبدء خادم الاستدلال، مع إمكانية تحديد `--host`.
تكوين النماذج: قدم نماذج الدردشة مثل Qwen3.5 أو Gemma 4 مباشرة، أو دمج محولات Open-Jev.
إرسال الطلبات: تفاعل مع الخادم باستخدام واجهة برمجة التطبيقات `/v1/systemone` لإرسال الحالات والأسئلة.
معالجة المدخلات متعددة الوسائط: قم بتضمين مسارات الصور في الحالة وإرسال الوسائط للنماذج التي تدعم الصور.
حالات استخدام Flide
- نماذج القرار المعززة
- استدلال متعدد الوسائط
- معالجة دفعات متسقة
- إدارة حالة الوكيل
- خدمة LLM عالية الأداء
- البحث والتطوير