الوصف
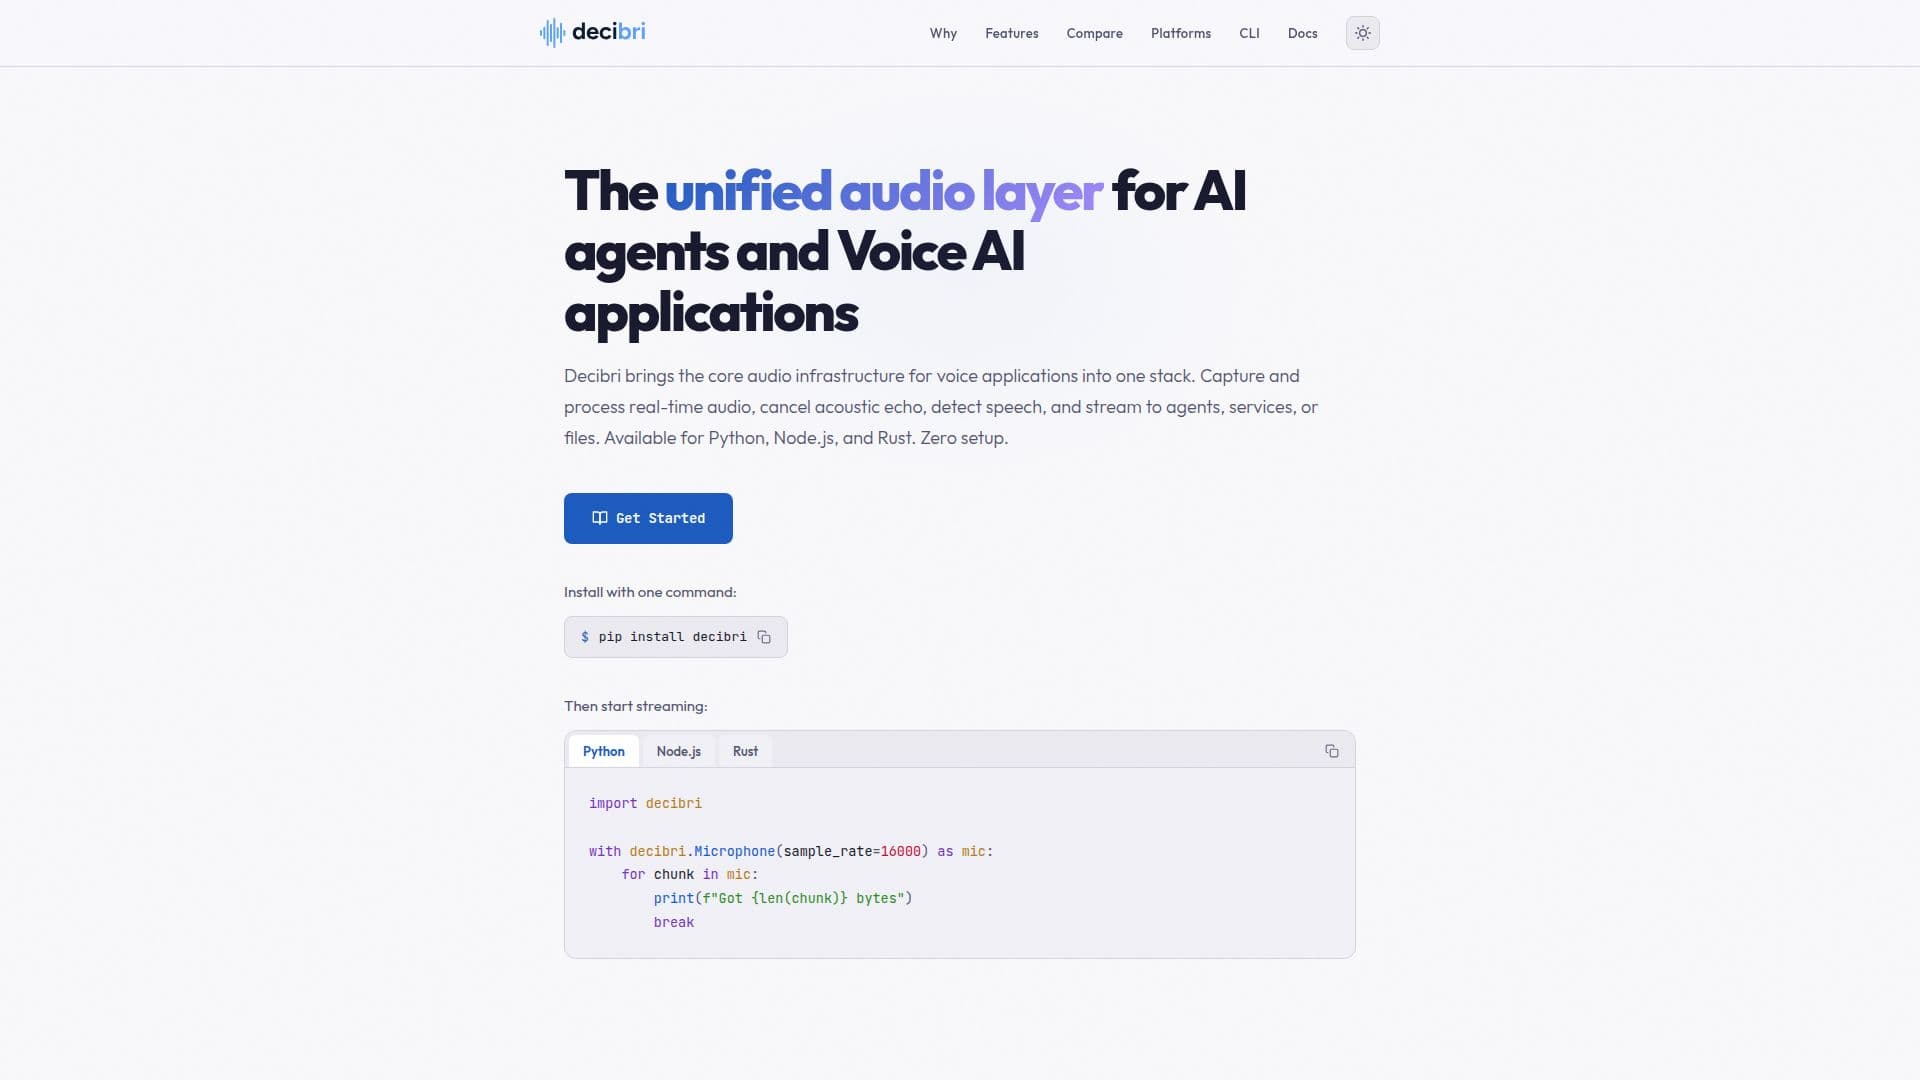
Decibri يعمل كطبقة صوت موحدة مصممة خصيصًا لوكلاء الذكاء الاصطناعي وتطبيقات الذكاء الاصطناعي الصوتي. يوفر قدرات صوتية أساسية في الوقت الحقيقي، بما في ذلك التقاط الميكروفون، وإخراج المتحدث، واكتشاف نشاط الصوت (VAD). تدعم المنصة عدة لغات برمجة، وهي Python وNode.js وRust، مما يجعلها متعددة الاستخدامات لمختلف بيئات التطوير.
قراءة المزيد
تتمثل إحدى المزايا الرئيسية لـ Decibri في سهولة التثبيت والتوافق عبر الأنظمة الأساسية. يوفر ثنائيات مسبقة البناء لـ Python وNode.js عبر جميع الأنظمة المدعومة (Windows وmacOS وLinux)، مما يلغي الحاجة إلى التجميع أو أدوات البناء المعقدة. تضمن هذه الطريقة "صفر إعداد" أن يتمكن المطورون من دمج وظائف الصوت في الوقت الحقيقي بسرعة في مشاريعهم. يتم تجميع النواة المكتوبة بلغة Rust، التي تدعم حزم Python وNode.js وRust، إلى كود أصلي، مما يضمن صوتًا منخفض الكمون بشكل متوقع مباشرة من طبقة الصوت في نظام التشغيل.
يقوم Decibri بالتقاط الصوت مباشرة من طبقة الصوت في نظام التشغيل، موفرًا قطع صوتية بحجم 100 مللي ثانية بشكل افتراضي بتنسيق PCM صحيح 16 بت، وهو التنسيق القياسي المتوقع من معظم محركات الكلام وكلمات الاستيقاظ مثل Vosk وsherpa-onnx وwhisper.cpp. يتوفر أيضًا تنسيق عائم 32 بت. يدعم تعبيرات تدفق الصوت لكل لغة، مما يسمح للمطورين بتوجيه الصوت إلى الملفات أو WebSockets أو وكلاء الصوت بكفاءة. تتضمن المنصة أيضًا نموذج Silero VAD v6.2 المدمج لاكتشاف الكلام بدقة في البيئات المزدحمة، يعمل محليًا عبر ONNX Runtime دون الحاجة إلى واجهات برمجة التطبيقات السحابية.
بعيدًا عن التقاط الصوت والتشغيل الأساسي، يقدم Decibri ميزات معالجة صوت متقدمة من خلال محرك التقاط الصوت (ACE)، بما في ذلك إزالة DC، وإزالة الضوضاء، والترشيح العالي، والتحكم التلقائي في الكسب، والتحديد. كما يوفر إلغاء صدى الصوت (AEC) لإزالة صوت مكبر الصوت من التقاط الميكروفون. لمعالجة غير المتصلة، يسمح معالج ملفات الصوت (AFP) بتكييف العينات المسجلة أو الموجودة في الذاكرة. يدمج Decibri مع العديد من مزودي تحويل الكلام إلى نص (STT)، سواء كانت سحابية (AssemblyAI وAWS Transcribe وAzure AI Speech وDeepgram وGoogle Cloud Speech-to-Text وMistral Voxtral وOpenAI Realtime API) أو محلية (Sherpa-ONNX وWhisper.cpp)، بالإضافة إلى تحويل النص إلى كلام (TTS) محلي باستخدام نموذج Kokoro واكتشاف الكلمات الرئيسية (KWS) مع Sherpa-ONNX.
تم بناء Decibri للأنظمة في الوقت الحقيقي، مما يضمن إدخال وإخراج صوت منخفض الكمون دون الحاجة إلى أدوات صوتية خارجية أو معالجة خاصة بالمنصة. يدعم العمليات غير المتزامنة في Python باستخدام `asyncio` ويعمل في كل من بيئات Node.js والمتصفح من حزمة واحدة. يوفر أداة `decibri-cli` قدرات سطر الأوامر لالتقاط الصوت، والتشغيل، وتعداد الأجهزة، مما يزيد من فائدته في البرمجة النصية وعمليات CI/CD.
- الفئةأدوات بناء وكلاء الذكاء الاصطناعي
- نموذج التسعيرمجاني
- النشرمحلي
- المنصاتWindows, macOS, Linux, Browser
الميزات الأساسية لـ Decibri
التقاط الميكروفون في الوقت الحقيقي
إخراج الصوت والتشغيل
اكتشاف نشاط الصوت (VAD)
دعم عبر الأنظمة الأساسية (Python وNode.js وRust)
ثنائيات مسبقة البناء لإعداد صفر
الوصول المباشر إلى طبقة الصوت في نظام التشغيل
إخراج صوت PCM 16 بت و32 بت عائم
دعم واجهة برمجة التطبيقات غير المتزامنة (asyncio لـ Python)
التوافق مع المتصفح (حزمة Node.js)
محرك التقاط الصوت (إزالة DC، إزالة الضوضاء، AGC)
إلغاء صدى الصوت (AEC)
اكتشاف الصوت المحلي باستخدام ML (Silero VAD)
التكامل مع خدمات STT السحابية
التكامل مع نماذج STT/TTS/KWS المحلية
واجهة سطر الأوامر (decibri-cli)
كيفية استخدام Decibri؟
تثبيت Decibri: استخدم `pip install decibri` لـ Python أو `npm install decibri` لـ Node.js للحصول على الثنائيات المسبقة البناء.
فتح الميكروفون: استخدم `decibri.Microphone.open()` في Python أو `new Microphone()` في Node.js لبدء التقاط الصوت.
بث الصوت: اقرأ قطع الصوت باستخدام المكررات في Python، أو تدفقات القراءة في Node.js، أو قنوات Rust.
معالجة الصوت: طبق التكييف المدمج مثل إزالة DC، إزالة الضوضاء، أو إلغاء صدى الصوت.
اكتشاف الكلام: قم بتمكين نموذج Silero VAD المدمج لاكتشاف نشاط الصوت محليًا.
التكامل مع خدمات الذكاء الاصطناعي: قم بتوجيه صوت PCM الخام إلى خدمات تحويل الكلام إلى نص، أو وكلاء الصوت، أو نماذج الذكاء الاصطناعي الأخرى.
تشغيل الصوت: استخدم واجهة برمجة التطبيقات الخاصة بـ Decibri لتشغيل الصوت عبر مكبر الصوت في النظام.
تسجيل إلى ملف: استخدم `record_to_file()` لتسجيل الصوت ببساطة أو التحكم الكامل في البث لحالات الاستخدام المتقدمة.
حالات استخدام Decibri
- وكلاء الذكاء الاصطناعي الصوتي في الوقت الحقيقي
- تكامل تحويل الكلام إلى نص
- اكتشاف نشاط الصوت
- تسجيل الصوت لـ ASR
- تطبيقات الصوت عبر الأنظمة الأساسية
- الخلفيات الصوتية على الخادم
- اكتشاف الكلمات الرئيسية
- الاتصال الصوتي الكامل الثنائي