الوصف
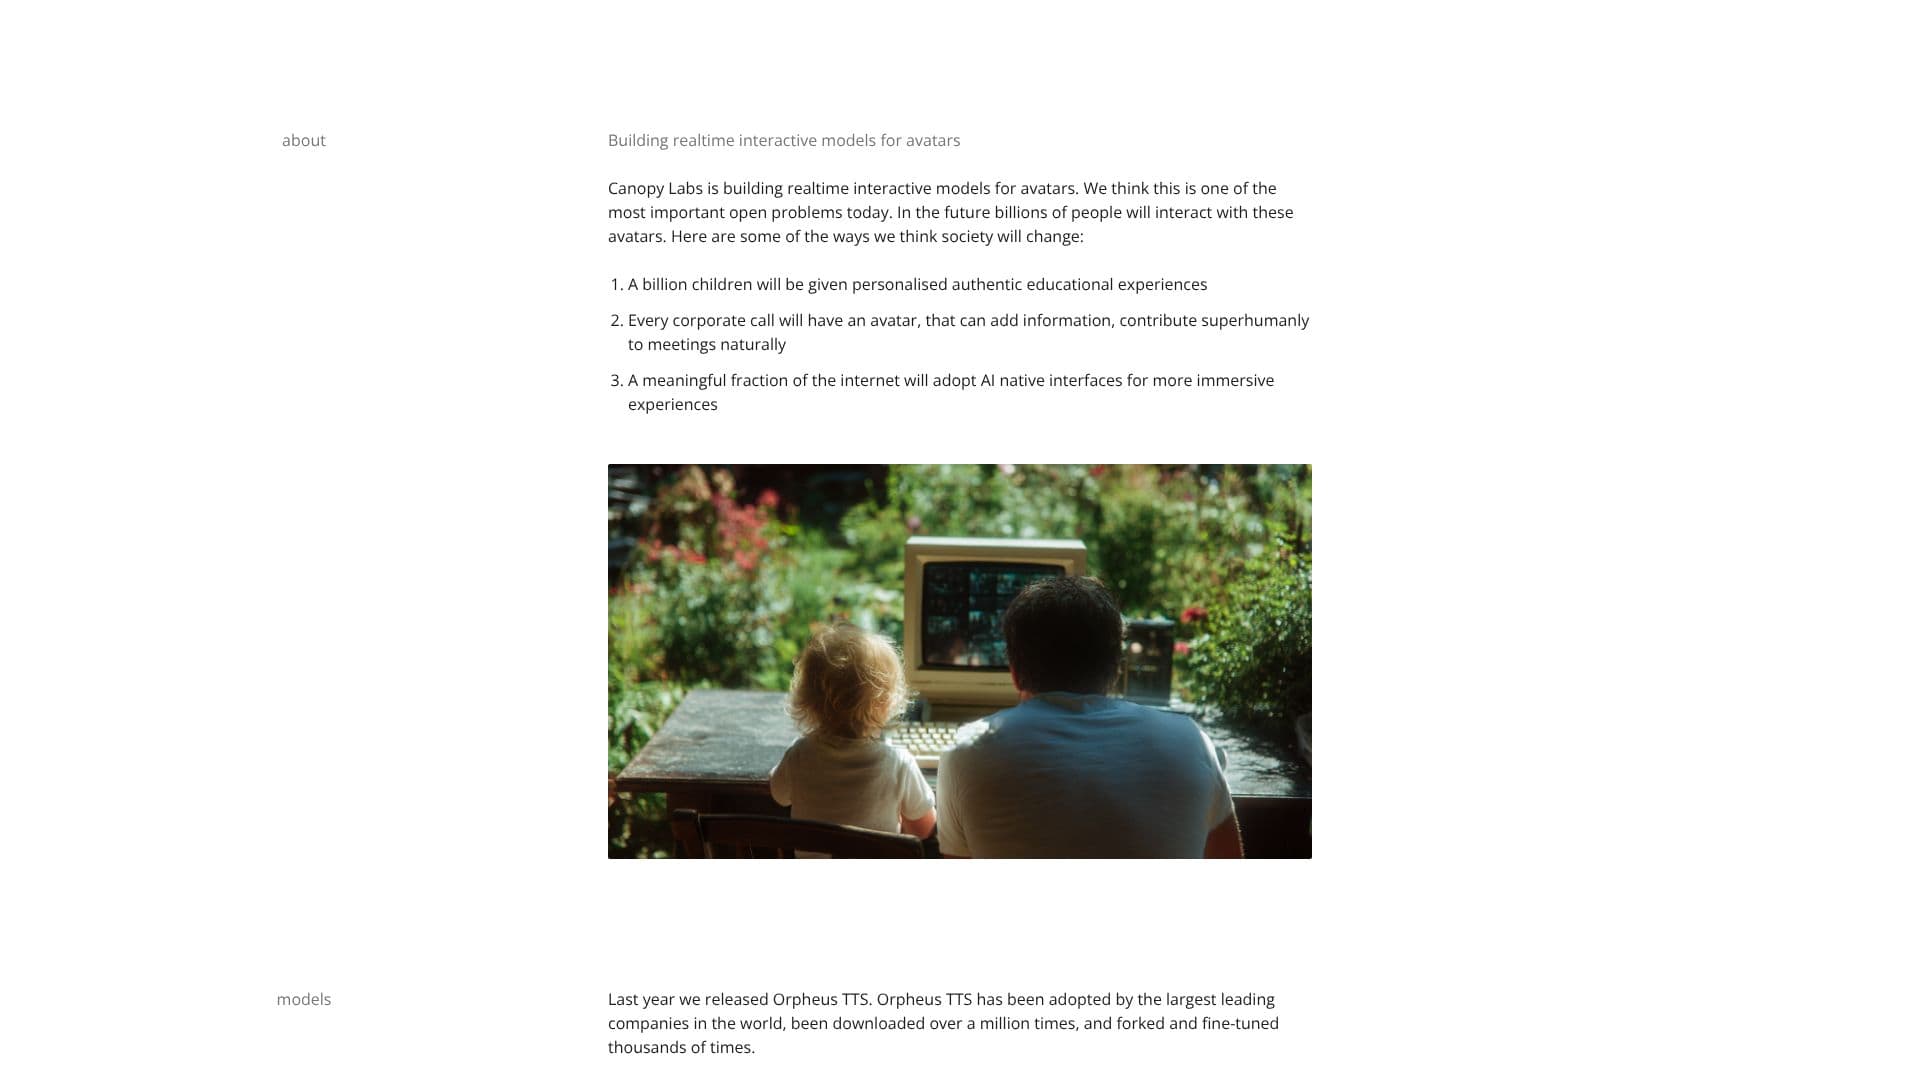
تصف Canopy Labs عملها بأنه بناء نماذج تفاعلية للصور الرمزية في الوقت الحقيقي، مع الهدف المعلن لتطوير بشر رقميين لا يمكن تمييزهم عن البشر الحقيقيين. تؤطر الشركة هذه القضية كمشكلة بحث مفتوحة تتوقع أن تعيد تشكيل كيفية تفاعل الناس مع البرمجيات، مدرجة سيناريوهات مثل تجارب التعليم الشخصية والصور الرمزية التي تشارك في الاجتماعات الشركات كاتجاهات تتوقع أن تمكنها التكنولوجيا؛ هذه هي رؤية الشركة المعلنة بدلاً من الميزات التي تم شحنها.
قراءة المزيد
أصدرت Canopy Labs سابقًا Orpheus TTS، الذي تقول إنه تم اعتماده من قبل الشركات، وتم تنزيله أكثر من مليون مرة، وتم تعديله أو تحسينه آلاف المرات (وفقًا لأرقام الشركة). منذ ذلك الحين، تقول Canopy Labs إنها جمعت 17 مليون دولار وتعمل على تطوير نماذج صوتية وصور رمزية أخرى لم يتم الإعلان عنها بعد.
المنتج المتاح اليوم هو Orpheus v1، نموذج تحويل النص إلى كلام متاح في فئتين، Base وFlash. إنه متعدد اللغات بشكل أصلي، يدعم الإنجليزية والهندية والماندرين والألمانية واليابانية والفرنسية والإيطالية والبرتغالية والروسية والإسبانية والكورية، ويدعم توجيهات المرحلة المضمنة في النص، مثل تحديد سطر بأنه مشوش أو عاطفي، لتشكيل كيفية تقديمه. تقول Canopy Labs إن النموذج لديه زمن استجابة منخفض للغاية، مع زمن استجابة p99 ضمن 30 مللي ثانية من خط الأساس. يأتي مع مكتبة صوتية تحتوي على أكثر من 30 صوتًا مسبق الإعداد، ويمكن لاستنساخ الصوت الاحترافي أو لمرة واحدة بناء صوت علامة تجارية مخصص من بضع ساعات من الصوت.
بالنسبة للعملاء من الشركات، يمكن نشر Orpheus على الخادم المحلي أو في سحابة خاصة مع دعم أولوية واتفاقية مستوى الخدمة، بدلاً من الاعتماد فقط على واجهة برمجة التطبيقات المستضافة. على موقعها، تعرض Canopy Labs النموذج عبر عدة أنماط تسليم مسبقة الإعداد، بما في ذلك صوت دعم العملاء، ونبرة تأملية، وقراءة مسرحية، وسرد لتعلم اللغة، وصوت مدرب تأمل، لإظهار نفس النموذج وهو يتعامل مع سجلات مختلفة. لا تنشر Canopy Labs تسعيرًا عامًا لـ Orpheus على موقعها.
- الفئةمولّدات الصور الرمزية بالذكاء الاصطناعي
- النشرسحابي
- المنصاتالويب
الميزات الأساسية لـ Canopy Labs
نموذج تحويل النص إلى كلام (Orpheus v1) متاح في فئتي Base وFlash
متعدد اللغات بشكل أصلي عبر إحدى عشر لغة بما في ذلك الإنجليزية والهندية والماندرين
يدعم توجيهات المرحلة المضمنة للتحكم في تقديم العاطفة للسطر
يقدم استنساخ صوت احترافي أو لمرة واحدة من بضع ساعات من الصوت
يوفر مكتبة تحتوي على أكثر من 30 صوتًا مسبق الإعداد
يدعي زمن استجابة منخفض للغاية، مع p99 ضمن 30 مللي ثانية من خط الأساس
يدعم نشر الشركات على الخادم المحلي أو السحابة الخاصة مع دعم اتفاقية مستوى الخدمة
يبحث في نماذج الصور الرمزية التفاعلية في الوقت الحقيقي بخلاف منتج الصوت الذي تم شحنه
كيفية استخدام Canopy Labs؟
اختر فئة النموذج: اختر Orpheus v1 Base أو Flash حسب احتياجات زمن الاستجابة والجودة.
اختر أو استنسخ صوتًا: استخدم صوتًا من المكتبة أو استنسخ صوتًا مخصصًا من عينة صوتية.
اكتب النص: أضف توجيهات المرحلة لتشكيل التقديم، مثل النغمة أو العاطفة.
اختر طريقة النشر: استخدم النموذج المستضاف أو رتب لنشره على الخادم المحلي أو السحابة الخاصة.
دمج الناتج: أدخل الكلام الناتج في منتج أو صورة رمزية أو سير عمل دعم.
حالات استخدام Canopy Labs
- نماذج أولية لمنتجات الصوت
- أصوات دعم العملاء
- سرد تعلم اللغة
- نشر الشركات على الخادم المحلي