الوصف
التعبيرات النمطية، التي يشار إليها غالبًا باسم RegEx، هي أدوات قوية لمطابقة الأنماط في النصوص. ومع ذلك، يمكن أن يكون بناء الجمل الخاص بها صعبًا للغاية في التعلم والتطبيق، مما يشكل حاجزًا كبيرًا للعديد من المطورين ومحللي البيانات والمتخصصين في تكنولوجيا المعلومات. تعالج AutoRegex هذا التحدي من خلال توظيف الذكاء الاصطناعي المتقدم ومعالجة اللغة الطبيعية (NLP) لسد الفجوة بين اللغة البشرية والأنماط التي يمكن للآلة قراءتها.
قراءة المزيد
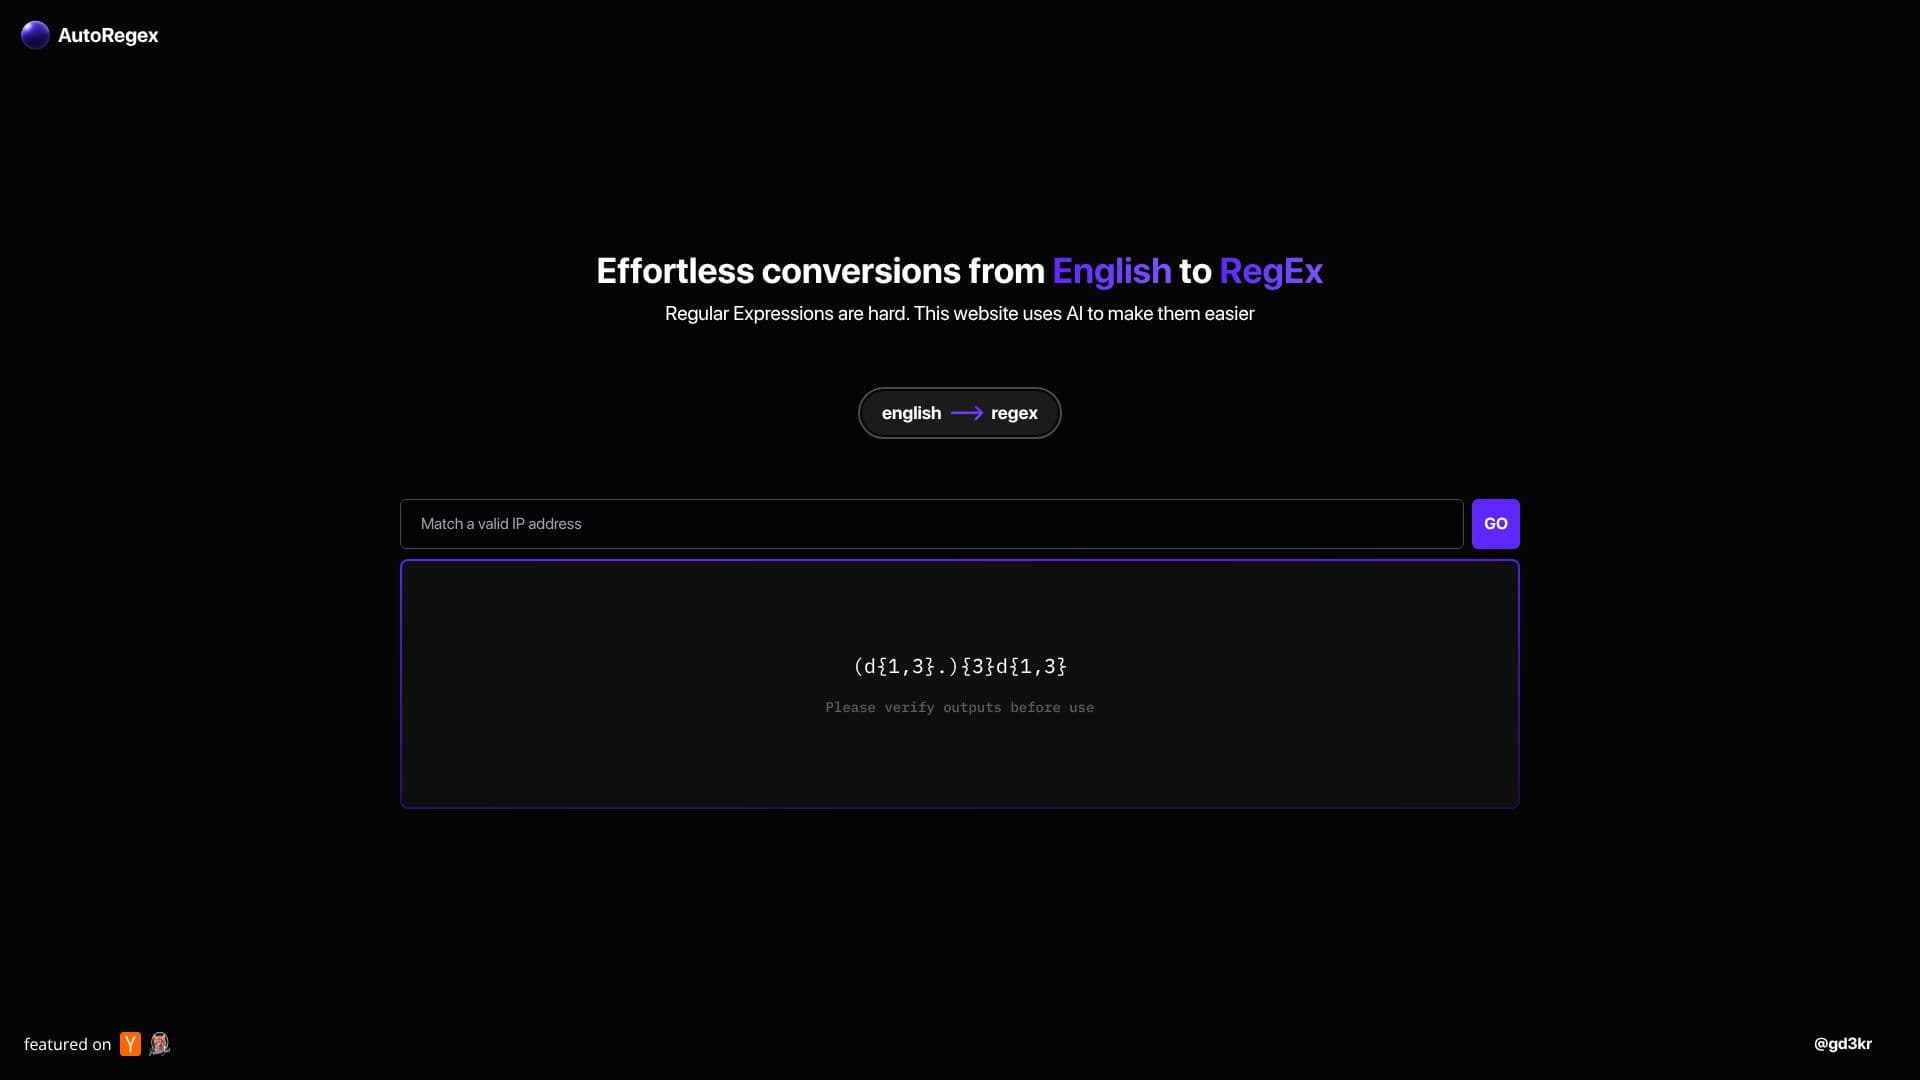
تكمن الوظيفة الأساسية لـ AutoRegex في قدرتها على تفسير استعلامات اللغة الطبيعية وترجمتها إلى كود تعبيرات نمطية وظيفي. يمكن للمستخدمين ببساطة وصف النمط الذي يبحثون عنه باللغة الإنجليزية العادية، مثل "مطابقة عنوان بريد إلكتروني" أو "العثور على جميع أرقام الهواتف بتنسيق معين"، وسيقوم محرك الذكاء الاصطناعي بإنشاء RegEx المقابل. هذا يقلل بشكل كبير من الوقت والجهد المطلوبين لإنشاء أنماط معقدة، مما يضفي طابعًا ديمقراطيًا على استخدام RegEx.
تم تصميم AutoRegex لمجموعة واسعة من المستخدمين الذين يعملون بشكل متكرر مع بيانات نصية ويحتاجون إلى مطابقة فعالة للأنماط. يشمل ذلك مطوري البرامج الذين يحتاجون إلى التحقق من صحة تنسيقات الإدخال أو تحليل ملفات السجل، وعلماء البيانات الذين يقومون بتحليل النصوص وتنظيف البيانات، ومتخصصي الأمن السيبراني الذين يحللون حركة مرور الشبكة، ومديري الأنظمة الذين يقومون بأتمتة المهام. تجعل الواجهة البديهية للأداة إمكانية الوصول إليها حتى لأولئك الذين لديهم خبرة سابقة محدودة في التعبيرات النمطية.
الفائدة الأساسية لـ AutoRegex هي قدرتها على تقليل منحنى التعلم المرتبط بالتعبيرات النمطية بشكل كبير. من خلال تجريد بناء الجمل المعقد، فإنه يسمح للمستخدمين بالتركيز على تحديد متطلبات أنماطهم بدلاً من التعامل مع مجموعات الأحرف المعقدة والأحرف الوصفية. يؤدي هذا إلى دورات تطوير أسرع، وأخطاء أقل في مطابقة الأنماط، وزيادة الإنتاجية. تشير قدرات التعلم المستمر للذكاء الاصطناعي أيضًا إلى إمكانية تحسين الدقة والتعامل مع الطلبات الأكثر دقة بمرور الوقت.
بينما تهدف الأداة إلى تبسيط إنشاء RegEx، من الضروري للمستخدمين التحقق من المخرجات التي تم إنشاؤها. يمكن أن تعني تعقيدات اللغة والفروق الدقيقة في مطابقة الأنماط أن RegEx التي تم إنشاؤها بواسطة الذكاء الاصطناعي قد تتطلب تعديلات طفيفة لتناسب الحالات الطرفية أو المتطلبات المحددة بشكل مثالي. توفر AutoRegex نقطة انطلاق قوية، مما يمكّن المستخدمين من تحقيق أهدافهم في مطابقة الأنماط بكفاءة أكبر من أي وقت مضى.
- الفئةمساعدو البرمجة بالذكاء الاصطناعي
- نموذج التسعيرمجاني مع ميزات مدفوعة
- النشرسحابي
- المنصاتالويب
الميزات الأساسية لـ AutoRegex
تحويل الأوصاف الإنجليزية إلى RegEx باستخدام الذكاء الاصطناعي
الاستفادة من معالجة اللغة الطبيعية (NLP) للتفسير
تبسيط بناء جمل RegEx المعقد
تقليل منحنى التعلم للتعبيرات النمطية
المساعدة في مطابقة الأنماط للبيانات النصية
إنشاء كود RegEx وظيفي من اللغة العادية
تبسيط عملية إنشاء أنماط RegEx
مساعدة المطورين وعلماء البيانات والمتخصصين في تكنولوجيا المعلومات
توفير نقطة انطلاق لإنشاء RegEx
تهدف إلى تحسين الدقة في مطابقة الأنماط
كيفية استخدام AutoRegex؟
وصف النمط: وضح بوضوح نمط النص الذي تحتاج إلى مطابقته باللغة الإنجليزية العادية.
إدخال الوصف: أدخل وصفك باللغة الإنجليزية في واجهة AutoRegex.
إنشاء RegEx: يقوم الذكاء الاصطناعي بمعالجة مدخلاتك وإنشاء تعبير نمطي مقابل.
التحقق من المخرجات: راجع RegEx الذي تم إنشاؤه للتأكد من أنه يطابق متطلباتك بدقة.
التحسين (إذا لزم الأمر): قم بإجراء أي تعديلات طفيفة على RegEx للحالات الطرفية المحددة.
التنفيذ: استخدم RegEx الذي تم التحقق منه في تطبيقك أو سير عملك.
حالات استخدام AutoRegex
- التحقق من صحة البريد الإلكتروني
- مطابقة أرقام الهواتف
- تحليل ملفات السجل
- تنظيف البيانات
- مطابقة أنماط عناوين URL
- تحليل النصوص
- التحقق من صحة حقول الإدخال